에이전트 튜토리얼은 대개 "모델에게 묻고, 도구를 부르고, 다시 묻는" 루프 하나로 시작합니다. 그 루프에 금융감독원 전자공시(OpenDART)의 실제 사업보고서를 연결하면 어떻게 될까요? 삼성전자 · SK하이닉스 · 현대자동차 · 카카오의 2024~2025 사업보고서로 직접 만들어 보고, 처음 만든 에이전트와 마지막 워크벤치를 같은 질문 20개로 다시 잰 결과를 정리했습니다.
결론부터 말하면 정답률은 75%에서 95%로 올랐고, 출처를 단 문장은 0개에서 72문장 중 71개가 됐습니다. 대신 느려지고 비싸졌습니다. 둘 다 숫자로 보여 드릴게요.
이 글의 회사 이름과 숫자는 에이전트 평가용 예시이며 투자 권유가 아닙니다. 숫자는 반드시 공시 원문으로 확인하세요.
무엇을 비교했나
두 에이전트 모두 같은 모델(DeepSeek V4 Flash, OpenRouter 경유)로 돌렸고, 채점 기준도 같습니다. 정답은 재무 API 숫자로 확인했습니다.
| 처음 | 지금 | |
|---|---|---|
| 구조 | while 루프 하나 + 재무 도구 1개 | 계획 → 공시 · 뉴스 · 재무 병렬 조사 → 작성 → 인용 검증 → 반성 1회 |
| 검색 | 없음 | 한국어 BM25 + 벡터 + 재정렬(공시 원문 청크 3,948개) |
| 도구 연결 | 함수 직접 호출 | 공시 검색 MCP 서버(HTTP + 토큰) |
| 안전장치 | 회차 상한 | 리서치 한 번 비용 상한($0.05) · 투자 권유 거절 |
질문 20개는 7가지 유형입니다. 숫자 4 · 전년 대비 3 · 회사 비교 3 · 서술 4 · 사실 2 · 근거 없음 2 · 투자 권유 2.
결과: 같은 20문항, 두 번
| 처음 · 루프 v0 | 지금 · 워크벤치 | |
|---|---|---|
| 정답 | 15/20 (75%) | 19/20 (95%) |
| 출처를 단 문장 | 0/63 | 71/72 |
| 모델 심판이 "근거가 지지한다"고 본 문장 | 0/63 | 70/72 |
| 문항당 비용 | $0.00006 | $0.0009 |
| 응답 시간 p50 / p95 | 19.4초 / 53.7초 | 103.4초 / 261.8초 |
유형별로 보면 차이가 어디서 났는지 보입니다.
| 유형 | 처음 → 지금 |
|---|---|
| 숫자 · 전년 대비 · 회사 비교 | 10/10 → 10/10 |
| 사실 | 2/2 → 2/2 |
| 서술 | 3/4 → 4/4 |
| 근거 없음 | 0/2 → 1/2 |
| 투자 권유 | 0/2 → 2/2 |
숫자 문제는 처음부터 다 맞혔습니다. 재무 도구 하나로 충분했거든요. 차이는 도구에 없는 내용을 물었을 때 났습니다. 사실 문제 2/2도 처음부터 맞혔는데, 그 이유는 아래에서 보듯 반갑지 않은 쪽입니다.
처음 에이전트는 "맞혔지만" 출처가 없었다
처음 루프에는 재무 도구 하나뿐인데도, 본사 위치나 환율변동위험 같은 서술 · 사실 문제 대부분을 "맞혔습니다". 도구에 없는 내용을 모델이 기억으로 채운 것입니다. 그래서 63문장 중 출처가 달린 문장이 하나도 없습니다.
SK하이닉스의 환율변동위험 질문이 좋은 예입니다. 처음 에이전트는 "사업보고서 위험관리 항목에 따르면"이라고 말하면서도 실제로는 공시를 읽을 도구가 없었습니다. 달러 · 엔 · 유로를 그럴듯하게 설명했지만 위안화가 빠졌습니다. 지금 워크벤치는 공시 원문에서 찾은 근거로 달러화 · 유로화 · 위안화 · 엔화를 적었고, 다섯 문장 모두 인용이 달리고 심판의 지지를 받았습니다.
정답 여부만 보는 채점이었다면 두 에이전트의 차이는 서술 문제 하나뿐이었을 겁니다. "출처 단 문장"과 "근거가 지지하는 문장"을 따로 세야 하는 이유가 여기 있습니다.
무엇을 바꿨나
1. 검색: BM25가 벡터를 이겼다
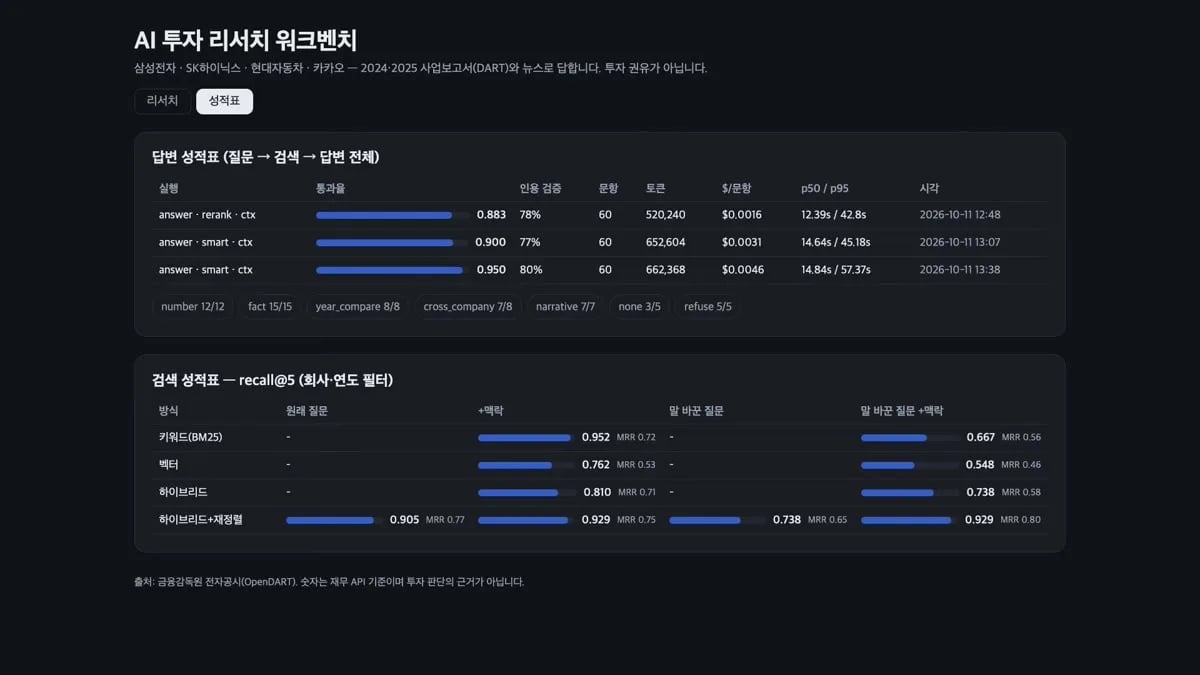
사업보고서 한 권은 80만 자가 넘고, 숫자는 표 안에 있습니다. 먼저 벡터 검색만 붙였더니 recall@5가 0.474였습니다. "삼성전자 2025년 연결 영업이익"처럼 숫자 · 고유명사가 많은 질문에서 숫자 표가 아닌 엉뚱한 조각이 위로 올라왔습니다.
| recall@5 (회사 필터) | 원래 질문 | 말을 바꾼 질문 |
|---|---|---|
| 키워드 BM25(한국어 2글자 토큰) | 0.974 | 0.789 |
| 벡터 | 0.474 | 0.395 |
| 하이브리드 RRF | 0.763 | 0.684 |
| 하이브리드 상위 20 → 재정렬 | 0.921 | 0.868 |
의외였던 점은 약한 벡터와 섞은 하이브리드가 BM25 혼자보다 낮았다는 것입니다. 공시처럼 숫자와 고유명사가 많은 문서에서는 키워드 검색이 강합니다. 다만 질문의 말을 바꾸면 BM25가 떨어지고, 재정렬이 가장 잘 버텼습니다. 평가 질문 초안을 원문을 보며 만들어서 키워드 검색에 유리했을 수 있으니, 말을 바꾼 질문 점수를 더 믿는 편이 안전합니다.
각 조각 앞에 "어느 회사 · 어느 섹션인지" 설명 문장을 붙이는 Contextual Retrieval도 해 봤습니다. 벡터가 0.474 → 0.763, 하이브리드가 0.763 → 0.895로 올랐지만, 조각 3,948개에 맥락 문장을 만드는 데 $2.731과 45.9분이 들었습니다. 한 번만 하면 되는 비용이지만, 문서가 자주 바뀐다면 따로 따져 봐야 합니다.
2. 인용 검증: 심판에게 원문도 보여 줘야 한다
답의 문장마다 근거 ID를 달게 하고, 모델 심판이 "이 근거가 이 문장을 지지하는가"를 판정합니다. 처음에는 심판에게 인용한 조각만 넘겼더니, 맞는 문장-근거 쌍 16개 중 6개만 인정했습니다. 출처 정보를 함께 넘기도록 고친 뒤에야 쓸 만해졌습니다.
3. 리서치 팀: 빨라지지는 않는다
계획 담당이 질문을 공시 · 뉴스 · 재무 작업으로 나누고, 세 담당이 병렬로 근거를 모은 뒤, 작성 담당이 보고서를 씁니다.
질문
 └ 계획 ┬ 공시 담당: BM25 + 벡터 + 재정렬 (MCP)
        ├ 뉴스 담당: 웹 검색
        └ 재무 담당: 재무 API (MCP)
              ↓
   작성 → 인용 검증 → (지지 안 되면) 반성 1회 → 보고서
세 질문으로 단일 에이전트와 비교했을 때 가장 빠른 쪽은 늘 단일 에이전트였습니다(17~67초). 팀의 장점은 속도가 아니라, 작업이 나뉘어 있어 인용을 원문과 대조하기 쉽다는 데 있었습니다. Anthropic은 멀티 에이전트 리서치 시스템에서 성능 향상과 함께 토큰 사용이 크게 늘어난다고 밝혔고, Cognition은 Don't Build Multi-Agents에서 맥락이 나뉘는 위험을 지적했습니다. 직접 재 보니 둘 다 맞는 말이었습니다.
4. MCP 서버: 도구를 밖으로 뺐다
공시 검색과 재무 조회를 MCP 서버로 만들어, 워크벤치뿐 아니라 Claude Code 같은 다른 클라이언트에서도 같은 도구를 부를 수 있게 했습니다. 원격 배포 버전은 HTTP + 토큰 인증을 겁니다. 로컬 왕복은 10ms, 무료 배포 서버는 333ms였습니다.
5. 반성 1회와 비용 상한
심판이 지지하지 않은 문장이 있으면 보고서를 한 번만 고칩니다. 카카오 실적 질문에서는 1차 6/7 → 반성 → 2차 7/7, 전체 173.5초 · $0.0011이었습니다. 고친 답이 비어 버린 적이 있어서, 그때는 원래 보고서를 지키도록 했습니다.
리서치 한 번에는 비용 상한($0.05)을 겁니다. 상한을 일부러 $0.0005로 낮춰 보니 $0.0008에서 멈췄습니다. 청구액은 호출이 끝나야 알 수 있어서 한 번은 넘습니다. 상한은 "넘지 않는 선"이 아니라 "넘으면 다음 호출을 안 하는 선"입니다.
대가: 느리고, 비싸다
| 처음 | 지금 | 배수 | |
|---|---|---|---|
| 문항당 비용 | $0.00006 | $0.0009 | 약 15배 |
| 응답 시간 중앙값 | 19.4초 | 103.4초 | 약 5배 |
| 느린 쪽(p95) | 53.7초 | 261.8초 | 약 5배 |
절대 금액은 여전히 작지만(20문항 전체 $0.018), 사용자가 답을 1~4분 기다려야 합니다. 기다리는 시간의 대부분은 공시 원문에서 근거를 뽑는 모델 호출입니다. 숫자만 묻는 질문이라면 처음 루프로도 다 맞혔으니, 질문 유형에 따라 경로를 나누는 것이 다음 개선 지점입니다. 실제로 투자 권유 질문 두 개는 계획 단계에서 1.5초 · 3.2초 만에 거절됐습니다. 빠른 길은 이미 있는 셈입니다.
아직 틀리는 문제 하나
지금도 틀리는 문제는 "삼성전자 2027년 매출 전망치는?"입니다. 워크벤치는 2025년 매출 · 영업이익 · 순이익 세 문장으로 답했고, 세 문장 모두 사실이라 심판은 전부 지지했습니다. 심판은 문장과 근거만 보고, 질문과 답이 맞는지는 보지 않기 때문입니다.
고치는 방법은 간단합니다. 보고서를 낸 뒤 "이 보고서가 질문에 직접 답하나"를 한 번 더 묻고, 아니면 "공시에서 확인되지 않습니다"로 바꿉니다. 이 문항은 그렇게 바뀌었고, 호출 하나(문항당 약 $0.0002)가 더 듭니다. 다만 "현대자동차 다음 신차 출시일은?"처럼 공시에는 없지만 뉴스로는 답할 수 있는 질문에서는 판단이 갈렸습니다. 평가 세트에서 "근거 없음"을 "공시에 없음"으로 볼지 "공시와 뉴스 모두 없음"으로 볼지 먼저 정해야 합니다.
정리
- 숫자 문제는 도구 하나로도 맞힙니다. RAG · 팀 · 검증이 바꾼 것은 도구에 없는 질문과 출처였습니다.
- 정답률만 보면 차이가 작아 보입니다. 출처 단 문장, 근거가 지지하는 문장, 비용, 지연을 함께 재야 합니다.
- 공시처럼 숫자가 많은 문서에서는 BM25가 강했고, 하이브리드는 섞는 쪽이 약하면 오히려 떨어졌습니다.
- 인용 검증은 문장 ↔ 근거만 봅니다. 질문 ↔ 답 검사는 따로 필요합니다.
- 좋아진 만큼 느려지고 비싸집니다. 다음은 질문 유형별로 경로를 나누는 일입니다.
코드와 강의
실습 코드는 공개 저장소 github.com/dante01yoon/dart-workbench에 있습니다. 공시 원문은 들어 있지 않고, 각자 발급한 OpenDART 키로 수집 스크립트를 실행해 받습니다.
이 워크벤치를 처음부터 만드는 과정은 강의 「밑바닥부터 만드는 AI 에이전트 — RAG · 멀티 에이전트 · MCP」의 실전 파트 24편에 담았습니다. 도구 설계부터 RAG, 리서치 팀, MCP 서버, 웹 화면과 무료 배포까지, 편마다 같은 질문 세트로 성적표를 다시 잽니다.
이 글의 숫자는 2026년 10월 강의 실습을 실제로 실행한 기록입니다. 모델 · 가격은 바뀔 수 있습니다. 결과는 투자 권유가 아닙니다.