딥시크(DeepSeek)가 10월 17일에 V4.1 Flash 업데이트를 냈습니다. 날짜를 따서 이름 뒤에 1017이 붙었습니다. 외부 평가에서 성능은 상위권인데 값은 쌉니다.
이 모델에서 눈여겨볼 점은 성능보다 모델 파일을 통째로 공개했다는 것입니다. 그래서 같은 모델을 여러 회사가 팔고, 어디서 언제 쓰느냐에 따라 값이 열 배까지 차이 납니다. 이 글에서는 다음 다섯 가지를 차례로 봅니다.
- 1017에서 무엇이 바뀌었나
- 오픈 웨이트란 무엇이고 왜 중요한가
- 싸게, 또는 무료로 쓰는 방법
- 딥시크가 직접 만든 코딩 도구로 한 번 써 보기
- 이전 버전과 같은 일을 시켜 직접 잰 결과
숫자 읽는 법. 이 글의 숫자에는 출처 종류를 붙였습니다. [자사 발표] 는 딥시크나 해당 서비스 회사가 스스로 낸 숫자, [독립 측정] 은 제3자 평가 기관이 잰 숫자, [직접 측정] 은 저희가 직접 돌려서 잰 숫자, [커뮤니티 보고] 는 개인 사용자가 올린 글(재현 안 됨)입니다.
1. 1017에서 무엇이 바뀌었나
1017은 새 모델이 아닙니다. 구조는 그대로 두고 학습 마무리 단계를 다시 한 개선판이고, 딥시크 웹 · 앱 · API에 이미 적용됐습니다(딥시크 공지).
- 점수: 딥시크가 공개한 표에서는 모든 항목이 이전 버전보다 올랐습니다. 터미널 작업 시험(Terminal-Bench 4.0)은 31.2에서 42.3으로 크게 뛰었습니다. [자사 발표] (모델 카드)
- 외부에서 다시 재면: 같은 시험을 평가 회사 Vals AI가 다시 쟀더니 31.82가 나왔습니다. 회사가 낸 숫자와 남이 잰 숫자는 이렇게 다를 수 있습니다. 시험을 돌리는 도구와 설정이 다르기 때문입니다. [독립 측정]
- 종합 점수: Artificial Analysis의 종합 지능 지수는 45로, 비교 대상 121개 중 2위입니다. 시험 문제 하나를 푸는 데 평균 $0.26가 들었습니다. [독립 측정] (Artificial Analysis)
- 답이 짧아졌다: 딥시크는 생각을 덜 길게 해서 코딩 작업 하나에 드는 돈이 약 $0.50에서 약 $0.20로 줄었다고 밝혔습니다. [자사 발표] (The Decoder 보도)
2. 오픈 웨이트란 무엇이고 왜 중요한가
AI 모델은 결국 수천억 개의 숫자 묶음입니다. 이 숫자를 가중치(weight) 라고 부릅니다. Claude나 GPT는 이 가중치를 회사 서버에만 두고, 우리는 그 서버에 질문을 보내 빌려 씁니다. 반면 오픈 웨이트(open weight) 모델은 가중치 파일 자체를 공개합니다. 누구나 내려받아 자기 컴퓨터에서 돌리고, 고치고, 다시 배포할 수 있습니다.
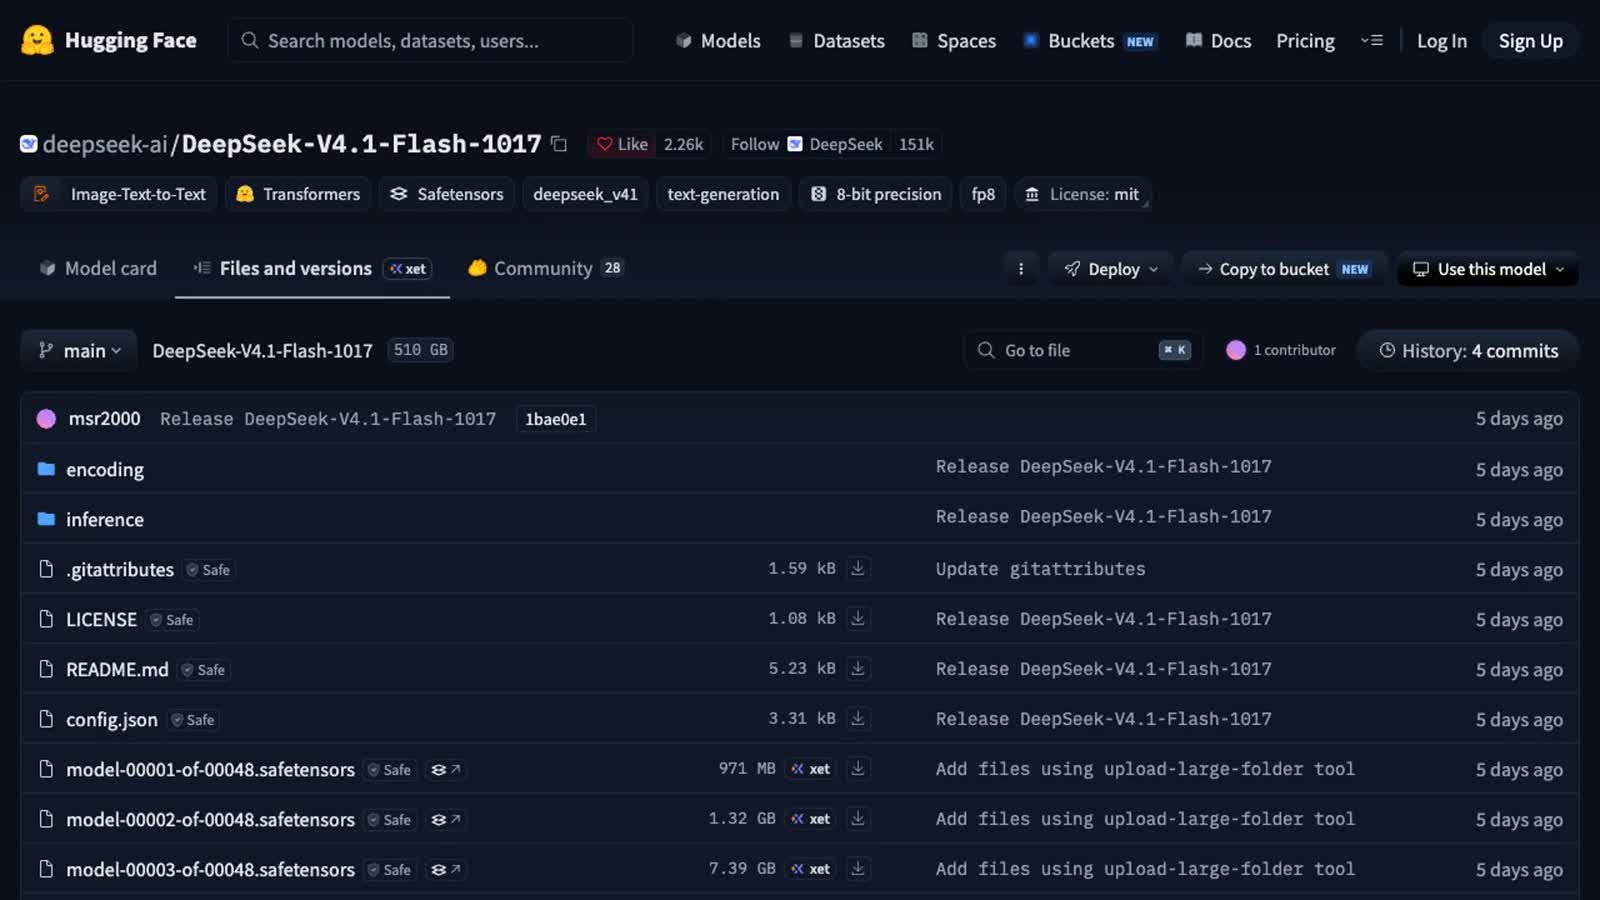
- 모델 공유 사이트 허깅페이스에 파일 83개, 합계 약 510GB가 올라와 있습니다. 전체 파라미터(가중치 숫자의 개수)는 약 7,632억 개입니다. (허깅페이스)
- 라이선스는 MIT입니다. 회사에서 고쳐 쓰고, 팔고, 다시 배포해도 됩니다. 저작권 · 라이선스 고지만 남기면 됩니다. (MIT License)
- 다만 학습 데이터와 학습 코드는 공개하지 않았습니다. 오픈소스 AI 정의(OSAID 1.0)는 이것까지 요구하므로, "오픈소스"보다 "오픈 웨이트"가 정확한 표현입니다. (OSI 정의)
파일이 공개되면 세 가지 일이 생깁니다.
① 여러 회사가 같은 모델을 판다
OpenRouter(여러 AI 모델 제공사를 한곳에서 골라 쓰게 해 주는 중개 서비스)에서 1017을 파는 곳만 엔드포인트 29개, 약 25곳입니다(10월 22일 조회). 값은 100만 토큰 기준입니다. 토큰은 모델이 글을 읽고 쓰는 단위로, 대략 단어 조각 하나라고 보면 됩니다.
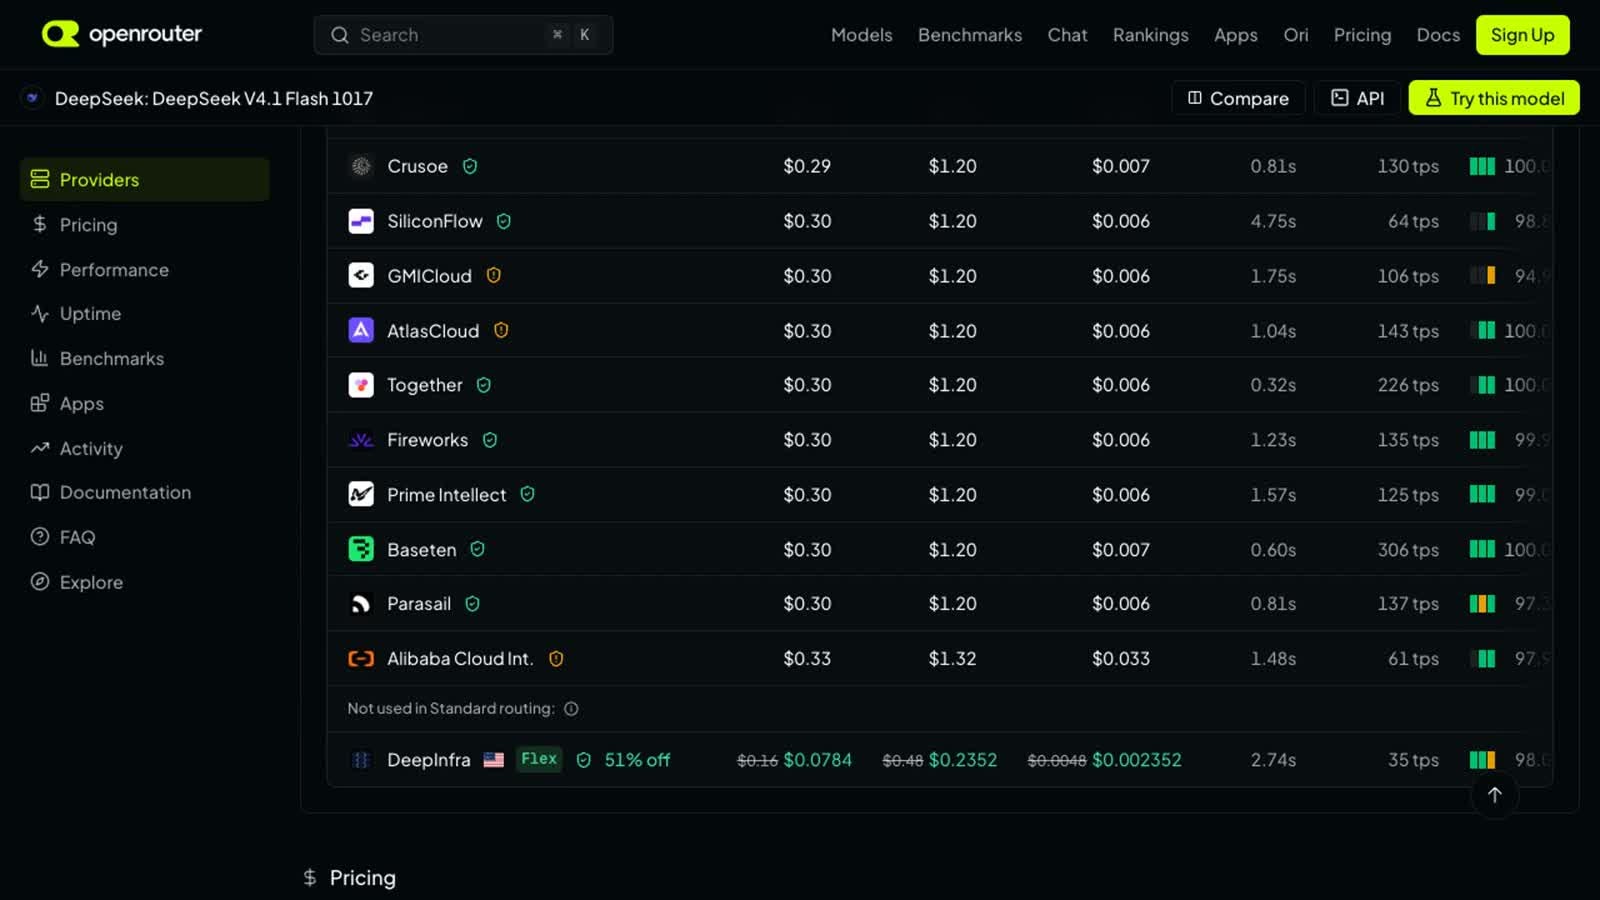
| 제공사 | 양자화 | 입력 | 출력 |
|---|---|---|---|
| OpenInference | fp4 | $0.07 | $0.50 |
| Sail Research | fp4 | $0.101 | $0.15 |
| DeepSeek(원조) | 미공개 | $0.15 | $0.60 |
| Together · Fireworks · Baseten 등 | fp8 또는 미공개 | $0.30 | $1.20 |
| Alibaba | 미공개 | $0.33 | $1.32 |
같은 모델인데 입력 가격은 약 5배, 출력 가격은 약 9배 차이 납니다(OpenRouter API). 표의 양자화는 가중치 숫자를 더 적은 비트로 줄여 저장하는 방법입니다(fp8 → fp4로 갈수록 작고 빠르지만, 품질이 조금 떨어질 수 있음). 같은 이름의 모델이라도 제공사마다 양자화 방식이 다르고, 제공사끼리 정확도를 비교한 공개 자료는 찾지 못했습니다.
속도도 다릅니다. Artificial Analysis가 9월판(1017 이전)을 제공사별로 잰 결과, 가장 빠른 곳은 초당 1,052토큰, 가장 느린 곳은 67토큰으로 약 15배 차이였습니다. [독립 측정] (제공사 비교)
저희도 직접 겪었습니다. 브라우저 업무 5개를 3번씩, 모델마다 15번 시켰는데(아래 5장), 1017의 1회 비용이 $0.003에서 $0.011까지 서너 배 출렁였습니다. OpenRouter가 실행마다 다른 제공사로 연결했기 때문입니다. [직접 측정]
② 같은 모델을 더 빠르게 고쳐 판다
국내 회사가 운영하는 OpenGateway는 같은 딥시크 모델을 자기 GPU에 맞게 손봐 deepseek-v4.1-flash-ultrafast라는 이름으로 팝니다. 초당 848토큰이 나온다고 밝혔습니다. [자사 발표]
이 숫자는 이렇게 읽어야 합니다.
- 2026년 9월 18일, 1017 업데이트 이전에 자사 서버에서 동시 요청 1개로 잰 값입니다.
- 이 버전은 생각하는 단계(reasoning)를 건너뛰고 바로 답합니다. 그래서 빠릅니다. 회사 페이지도 수학 · 증명처럼 단계적 추론이 필요한 일에는 원본 모델을 쓰라고 권합니다.
③ 회사가 자기 서버에서 돌린다
한 해외 커뮤니티에는 직원 40명(개발자 10명) 회사가 RTX 6000 Blackwell MaxQ GPU 4장짜리 서버(약 5만 5천 유로)에서 이전 세대인 DeepSeek V4 Flash를 사내 채팅 도우미 · 회의록 · 개발용 API로 쓴다는 글이 올라왔습니다. 회사 자료가 바깥으로 나가지 않는 것이 가장 큰 장점입니다. [커뮤니티 보고] (r/LocalLLaMA)
사람들도 바로 움직였습니다. 출시 닷새 만에 1017을 바탕으로 한 양자화 버전이 99개, 특정 일에 맞게 더 학습시킨(파인튜닝) 버전이 23개 올라왔습니다. NVIDIA도 직접 NVFP4 양자화판을 올렸습니다. (허깅페이스 모델 트리 · NVIDIA NVFP4)
그럼 집에서도 돌릴 수 있을까
- 원본 그대로 돌리려면 GPU 메모리가 최소 614GB 필요합니다(vLLM 공식 레시피 기준). 데이터센터급 장비입니다. (vLLM 레시피)
- 양자화로 줄여도 1비트 128~145GB, 4비트 약 305GB의 메모리가 필요합니다. (Unsloth 문서)
- 집 컴퓨터에서 줄인 버전을 돌렸다는 보고는 초당 3~27토큰 수준입니다. API(초당 200토큰 이상)와 체감 차이가 큽니다. [커뮤니티 보고] (r/LocalLLaMA)
저희 맥은 메모리가 36GB라 시도하지 않았습니다.
주의할 점: 데이터는 안 나가도, 성향은 파일 안에 남는다
직접 돌리거나 다른 회사 서버에서 쓰면 내 데이터가 딥시크 서버로 가지 않습니다. 하지만 미국 국립표준기술연구소(NIST) 산하 CAISI는 2025년 9월, 허깅페이스에서 받은 이전 세대 딥시크(V3.1)도 중국 정부 서사에 맞춘 답을 한다며 검열이 가중치 자체에 들어 있다고 평가했습니다(NIST 발표). 1017을 대상으로 한 CAISI 평가는 아직 찾지 못했지만, 미국 회사(Fireworks AI) 서버에서 돌린 V4.1 Flash도 천안문 1989 질문을 거절했다는 개인 테스트가 있습니다. [커뮤니티 보고] (글)
3. 싸게, 또는 무료로 쓰는 방법
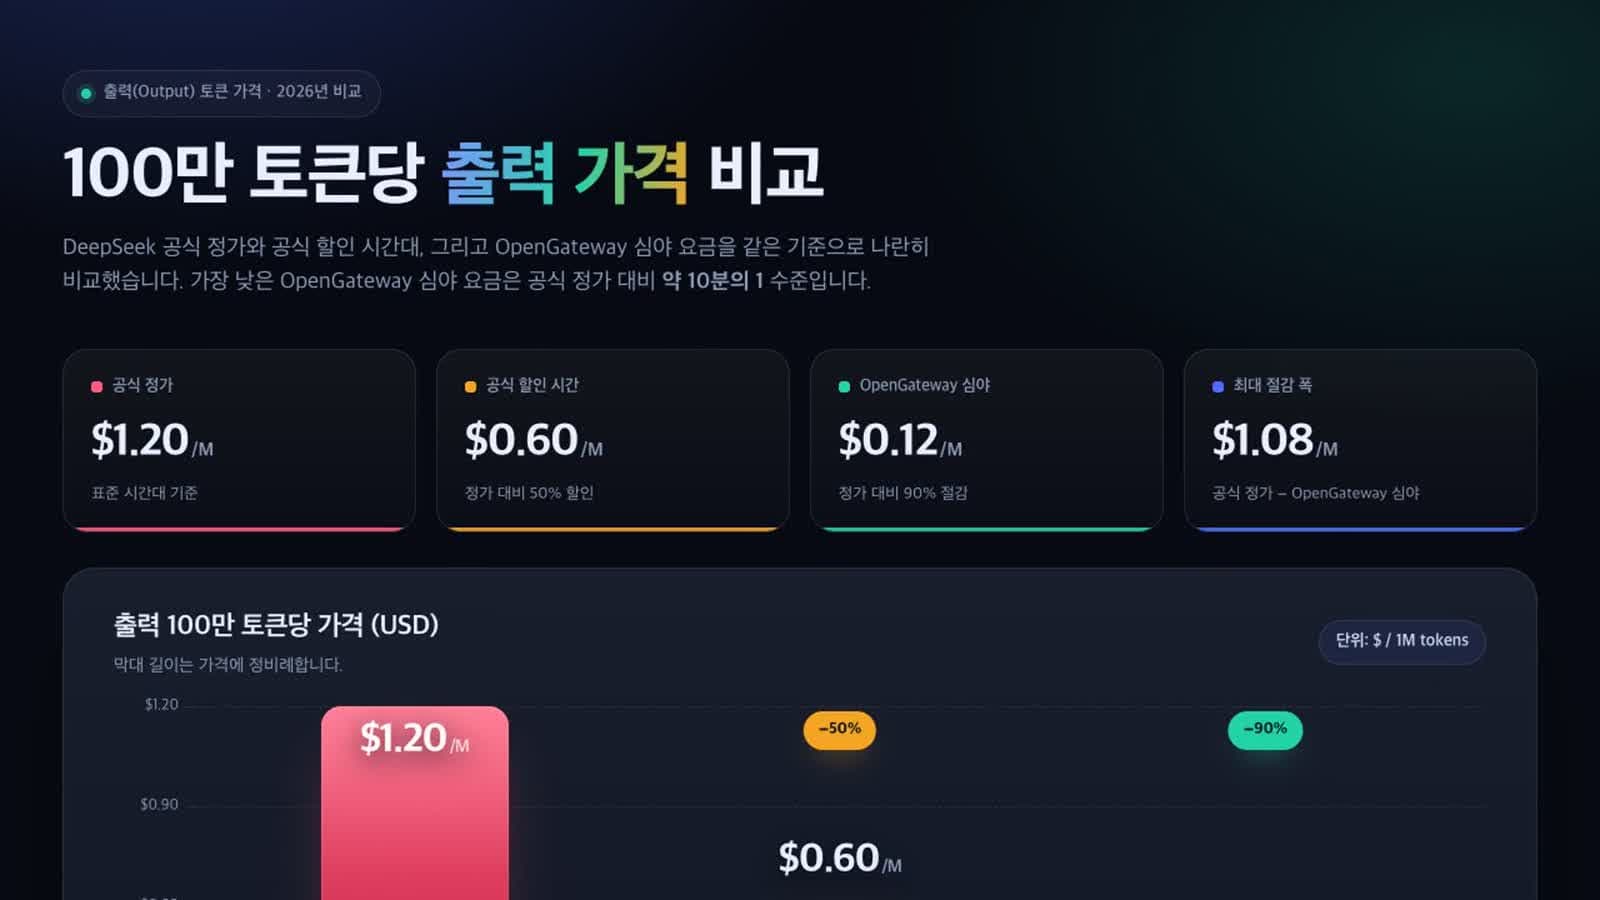
시간대 할인 ① 딥시크 공식 API — 바쁜 시간 빼면 반값
딥시크 공식 API는 시간대에 따라 값이 다릅니다(공식 가격표).
| 시간(한국 기준) | 입력(캐시 미적중) | 출력 |
|---|---|---|
| 평일 10 | $0.30 | $1.20 |
| 그 밖의 시간 · 주말 | $0.15 | $0.60 |
피크 시간은 공식 문서에 UTC 01:0004:00, 06:0010:00(월~금, 중국 공휴일 제외)로 적혀 있고, 한국 시간으로 바꾸면 위와 같습니다. 큰 일을 밤이나 주말에 몰아서 돌리면 그것만으로 반값입니다.
시간대 할인 ② OpenGateway — 10월 31일까지 최대 90% 할인
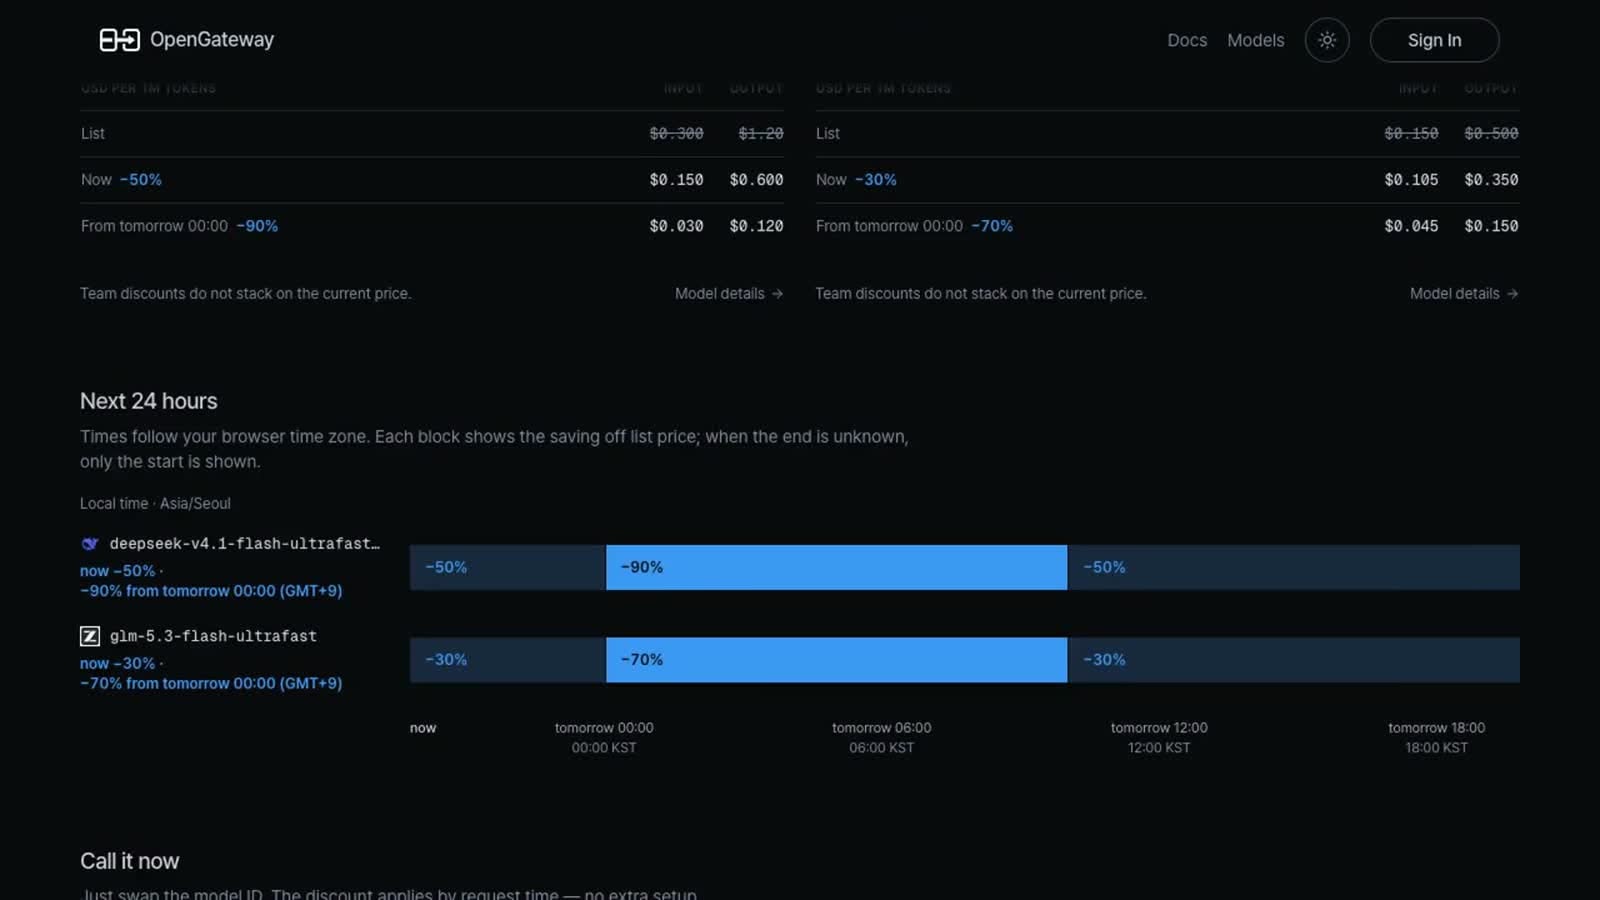
앞에서 본 OpenGateway의 ultrafast 버전은 10월 31일까지 할인 행사를 합니다(행사 페이지, 10월 22일 확인).
- 정가: 입력 $0.30, 출력 $1.20 (100만 토큰당)
- 평일 0시~10시(한국 시간) 와 10월 24~25일, 31일(토) 종일: 90% 할인 → 입력 $0.03, 출력 $0.12
- 그 밖의 시간: 확인 시점 기준 50% 할인
행사 조건은 바뀔 수 있으니 쓰기 전에 페이지를 다시 확인하세요. 그리고 이 버전은 생각 단계를 건너뛰는 빠른 버전이라는 점도 기억해 두세요.
OpenRouter를 쓴다면: 제공사를 정해 두기
OpenRouter 기본 설정은 요청마다 제공사를 가격에 따라 확률적으로 고릅니다. 그래서 비싼 곳에도 종종 걸립니다. 모델 이름 뒤에 :floor를 붙이면 가격순으로 고르고, 계정 설정에서 특정 제공사를 뺄 수도 있습니다(OpenRouter 문서). 저희 측정에서는 모델을 바꾸는 것보다 제공사를 정하는 것이 비용에 더 큰 영향을 줬습니다.
무료로 쓰는 길
- 딥시크 웹 · 앱 채팅: 무료이고 이미 1017로 서비스합니다. 다만 2025년 4월 한국 개인정보보호위원회가 딥시크 앱이 동의 없이 이용자 입력을 국외로 넘긴 사실을 확인한 적이 있으니, 민감한 내용은 넣지 않는 게 좋습니다. (RFA 보도)
- OpenCode 무료 모델: 코딩 도구 OpenCode가 DeepSeek V4.1 Flash를 기간 한정 무료 모델로 풀어 두었습니다. 공식 문서에는 1017 여부가 따로 표시돼 있지 않고, 사용 한도도 공개되지 않았습니다. (OpenCode Zen 문서)
- Tencent WorkBuddy: 데스크톱 앱 안에서 10월 31일까지 무료로 쓸 수 있습니다. API로 꺼내 쓸 수는 없습니다. (WorkBuddy 공지)
4. 딥시크가 만든 코딩 도구로 한 번 써 보기
딥시크는 Claude Code처럼 파일을 고치고 명령을 실행하는 코딩 에이전트 DeepSeek Harness도 오픈소스로 공개했습니다. 10월 17일 릴리스부터 1017을 지원하고, 아직 미리보기 단계입니다. (GitHub)
dsh 0.2.1-rc.2 웹 화면에서 OpenRouter로 연결한 1017에게 평소 말투로 이렇게 부탁했습니다.
딥시크 가격 비교 페이지를 index.html 하나로 만들어 줘. 출력 100만 토큰당 공식 정가 1.2달러,
공식 할인 시간 0.6달러, 오픈게이트웨이 심야 0.12달러야. 막대그래프로 크게 보여 줘.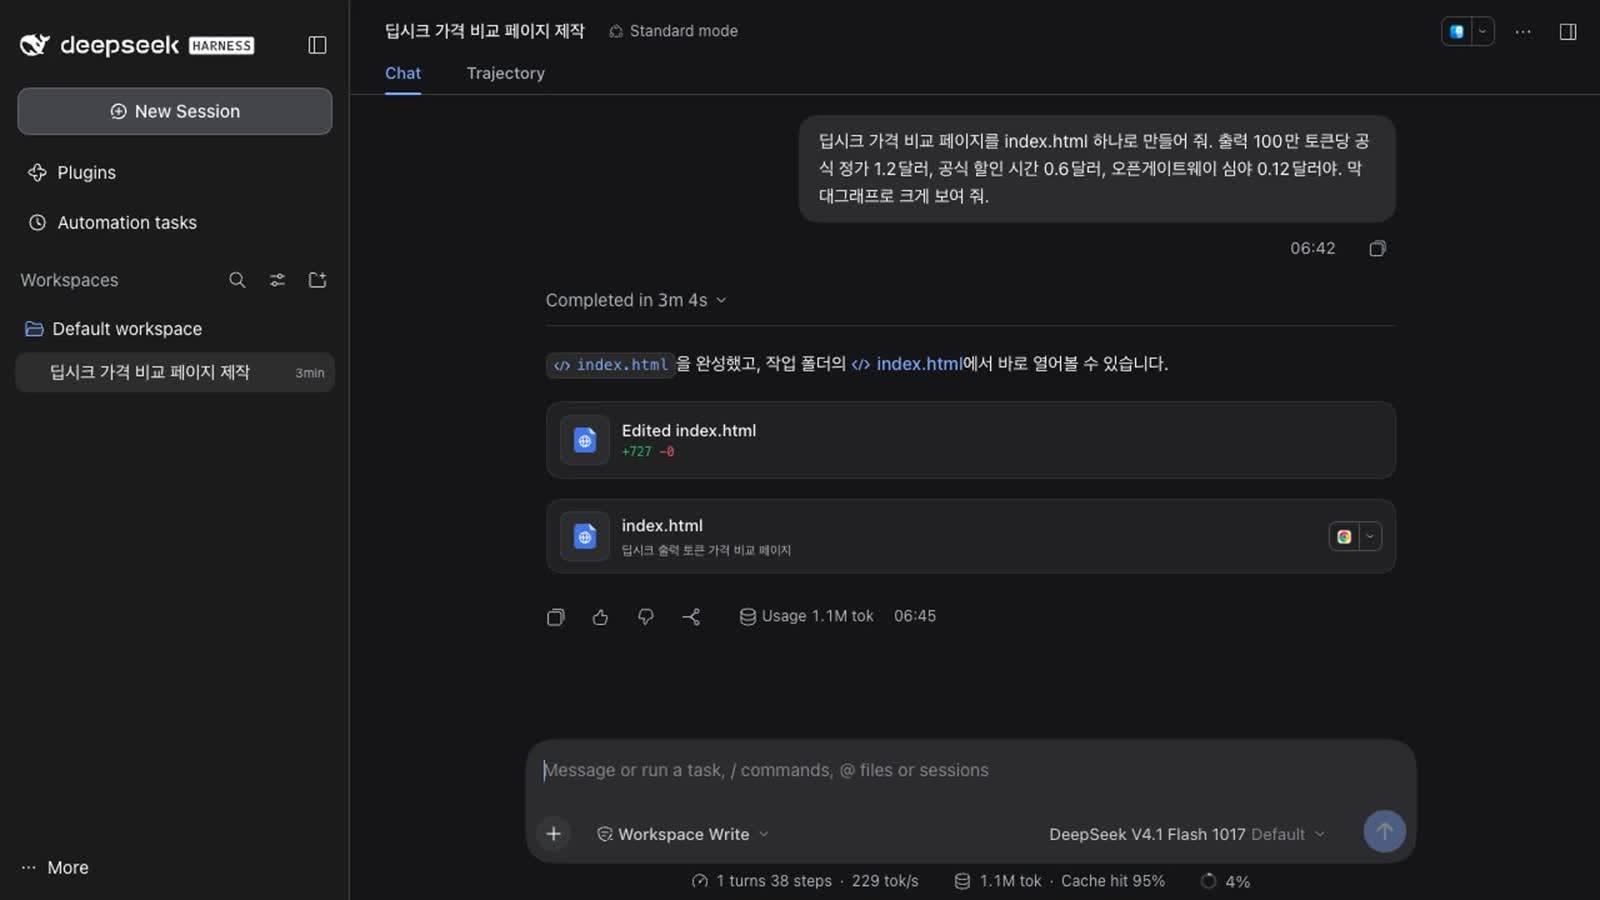
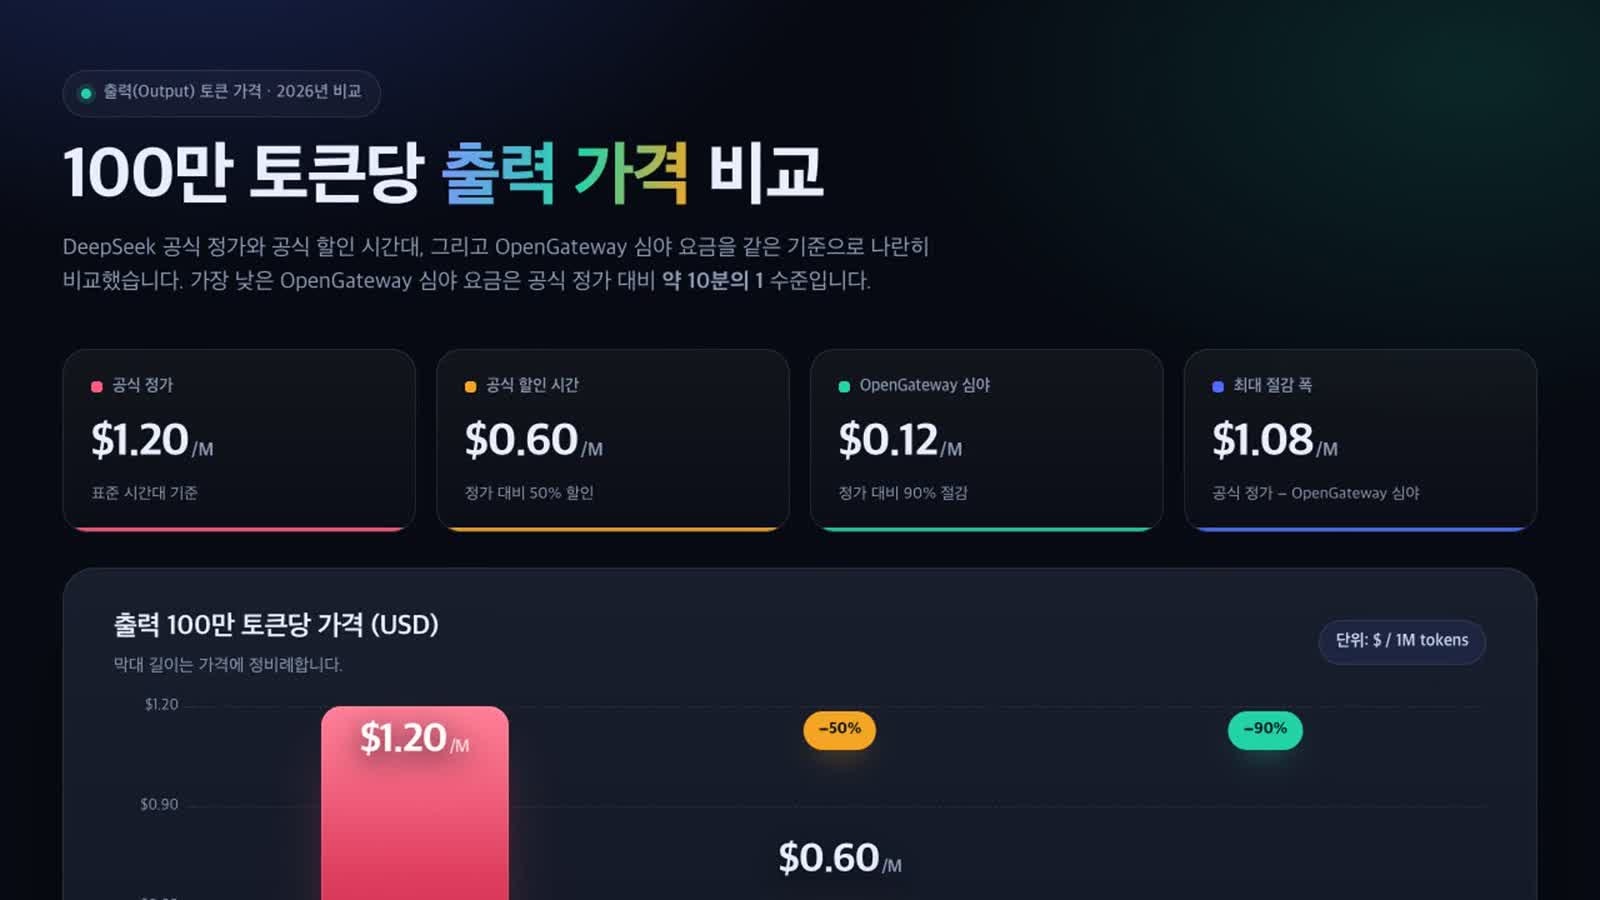
| 항목 | 값 [직접 측정] |
|---|---|
| 걸린 시간 | 3분 4초 |
| 단계(모델 호출) | 38회 |
| 결과물 | index.html 1개, 727줄 |
| 토큰 | 입력 약 104만(그중 캐시 약 99만) · 출력 1.3만 |
| 실제 청구액 | $0.0185 (OpenRouter 호출별 청구액 합계) |
2센트가 안 들었습니다. 다만 간단한 페이지 하나에 38단계는 꽤 많은 편입니다. 입력 대부분이 캐시(이미 읽은 내용을 다시 보낼 때 싸게 계산해 주는 기능)로 처리돼서 값이 낮게 나왔습니다.
5. 이전 버전과 같은 일을 시켜 직접 쟀다
이전 V4.1 Flash와 1017에 세 가지 일을 똑같이 시켰습니다. 모두 OpenRouter를 거쳤고, 비용은 OpenRouter가 기록한 실제 청구액입니다. [직접 측정]
① 평소 하던 브라우저 업무 — 둘 다 거의 만점
매일 쓰는 브라우저 에이전트에 모델 이름만 바꿔 붙이고, 웹에서 표 만들기 · GitHub 이슈 분류 · 할 일 앱 조작 같은 과제 5개를 모델마다 3번씩 시켰습니다.
| 이전 버전 | 1017 | |
|---|---|---|
| 정확도(총 207점) | 206 | 207 |
| 걸린 시간 중앙값 | 28초 | 39초 |
| 평균 출력 토큰 | 3,959 | 3,127 (−21%) |
| 1회 실제 비용(OpenRouter 기본 연결) | $0.0121 | $0.0062 |
이 정도 일로는 정확도 차이가 없습니다. 답이 짧아진 것은 딥시크 발표와 맞았습니다. 비용 차이는 모델보다 어느 제공사에 걸렸는지의 영향이 컸습니다. 각 모델의 최저가 제공사로 고정했다면 오히려 이전 버전이 1회 약 $0.0015로 1017(약 $0.0027)보다 쌌습니다.
② 모션 그래픽 만들기 — 결과는 비슷, 과정은 1017이 가벼웠다
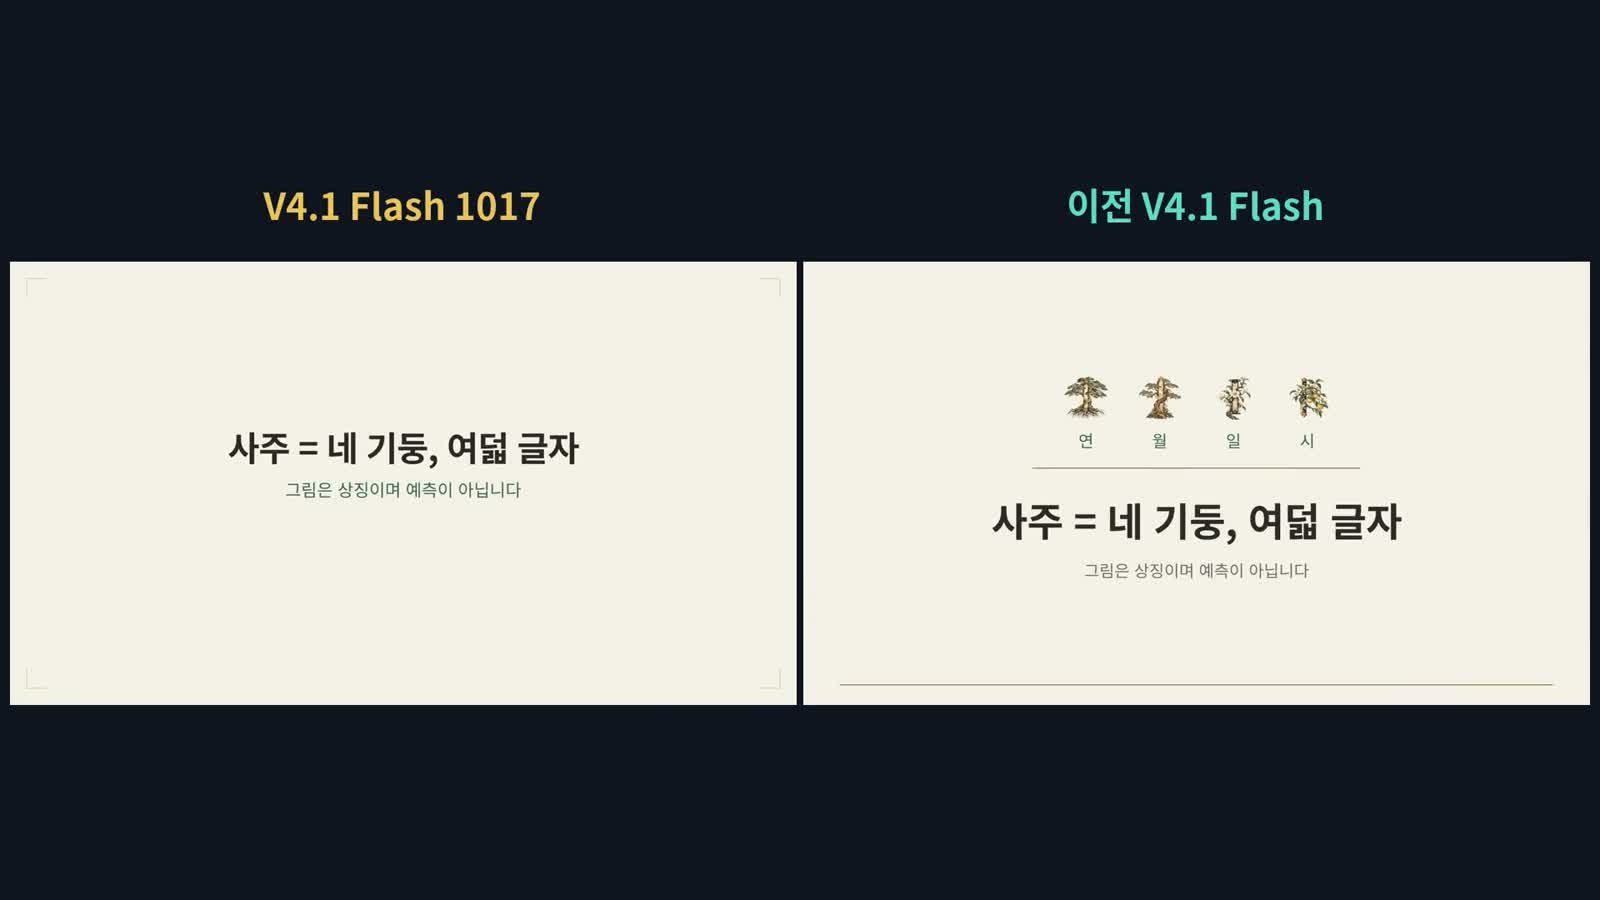
미리 만들어 둔 그림 소재로 "사주 기초" 20초 설명 영상(HTML 모션 그래픽)을 두 가지 지시문(A, B)으로 만들게 했습니다. 완성도는 비슷했습니다.
| 지시문 | 1017 | 이전 버전 |
|---|---|---|
| A | 129초 · 5.1만 토큰 · $0.065 | 215초 · 6.8만 토큰 · $0.061 |
| B | 337초 · 6.4만 토큰 · $0.033 | 349초 · 11.6만 토큰 · $0.109 |
B에서는 1017이 토큰을 절반 정도, 비용은 3분의 1 정도만 썼고, A에서는 비용이 비슷했습니다. 다른 주제(출력 한도 4.8만 토큰)에서는 이전 버전이 생각만 4.7만 토큰을 하다 한도에 걸려 아무것도 만들지 못한 일이 두 번 있었고, 1017은 같은 조건에서 두 번 다 성공했습니다.
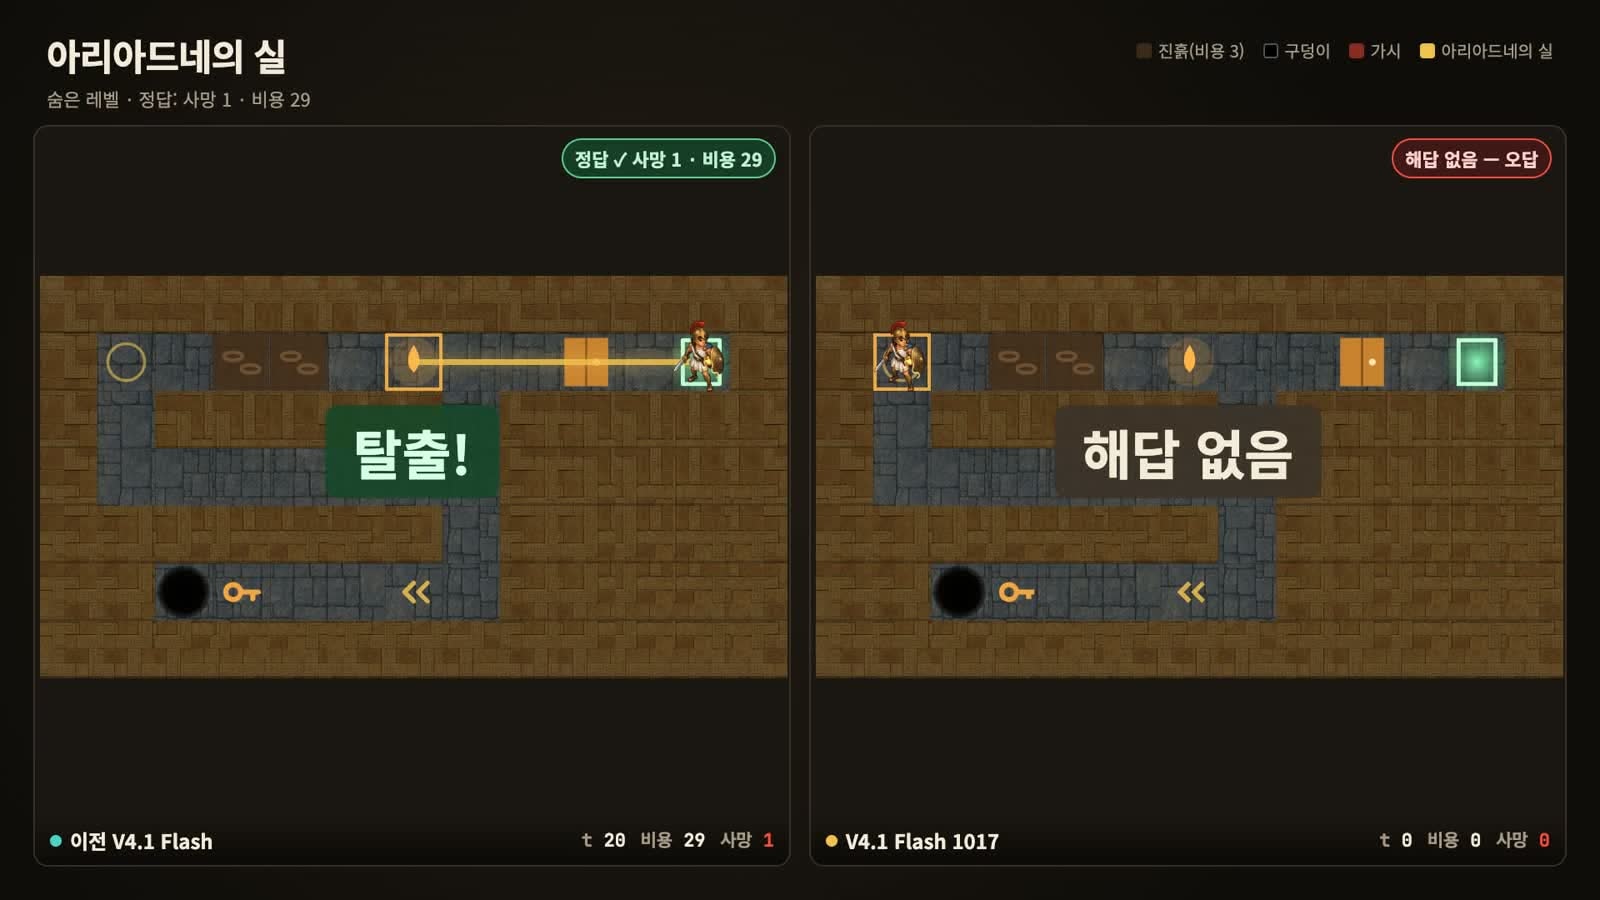
③ 미궁 탈출 프로그램 — 이번엔 이전 버전이 나았다
규칙 문서만 주고 가장 좋은 탈출 경로를 찾는 프로그램을 짜게 했습니다. 채점용 숨은 레벨 23개는 모델에게 보여 주지 않았습니다. 코딩 에이전트 Claude Code에 OpenRouter로 모델만 바꿔 연결했습니다.
| 이전 버전 | 1017 | |
|---|---|---|
| 1회차 | 23/23 · 18분 | 22/23 · 24분 |
| 2회차 | 23/23 · 23분 | 22/23 · 45분 시간 상한으로 중단 |
| 2회 합계 실제 비용 | $0.29 | $0.58 |
1017이 두 번 다 틀린 것은 같은 유형, 일부러 한 번 죽어야 탈출할 수 있는 레벨이었습니다. 이 어려운 알고리즘 과제에서는 이전 버전이 더 정확하고 비용은 절반이었습니다. 1017은 같은 문제를 더 오래 붙잡고 토큰을 약 2배 썼습니다.
정리하면
- 짧게 끝나는 일(브라우저 업무, 모션 그래픽)에서는 1017이 답이 짧고 대체로 더 가벼웠습니다.
- 오래 붙잡고 푸는 어려운 문제에서는 이번 시험에서 이전 버전이 더 좋았습니다.
- 시험은 과제마다 두세 번씩만 돌렸으니 참고용으로 봐 주세요. "1017이 모든 면에서 낫다"고 말하기는 어렵습니다.
실천 세 가지
- 큰 일은 밤이나 주말에 몰아서 돌리세요. 딥시크 공식 API는 바쁜 시간대를 피하면 반값이고, OpenGateway는 10월 31일까지 평일 심야와 지정된 주말에 90% 할인합니다.
- OpenRouter를 쓴다면 제공사를 정해 두고 값을 비교하세요. 같은 모델이라도 제공사에 따라 값이 서너 배 출렁였습니다. 양자화 방식도 함께 확인하세요.
- 업데이트가 나오면 내 일 두세 개로 직접 시켜 보고 고르세요. 발표 점수와 외부 측정이 다르고, 과제에 따라 새 버전이 더 나쁠 수도 있습니다.
딥시크는 파일이 공개돼 있어서 같은 모델을 어디서, 어떻게 쓸지 고를 수 있습니다. 그 선택이 가격과 속도를 바꿉니다.
이 글의 가격 · 행사 · 제공사 목록은 2026년 10월 19
22일에 확인한 내용이며 바뀔 수 있습니다. 직접 측정은 과제마다 23회만 돌린 결과입니다.