AI한테 회사 일을 물어보면 그럴듯하게 틀릴 때가 많습니다. 회사 지식이 위키, 공유 드라이브, 코드 주석, 선배 머릿속에 흩어져 있어서 AI가 맥락을 모르기 때문입니다. 그래서 다들 문서를 찾아서 붙여 주는 방식, RAG를 써 왔습니다.
그런데 올해 6월 구글이 "그냥 폴더에 잘 정리해 두라"는 형식을 냈습니다. 이름은 OKF(Open Knowledge Format) 입니다. 해외에서는 "폴더가 벡터 DB를 이겼다", "RAG는 끝났다" 같은 영상이 수십만 회씩 재생됐습니다. 그래서 직접 시험해 봤습니다.
이 글에서는 다음을 차례로 봅니다.
- RAG와 OKF는 각각 무엇이고, 어떻게 동작하나
- 구글 저장소 코드에는 무엇이 들어 있나
- 같은 질문 18개로 직접 잰 결과
- 구글 예제 속 "사람이 확인한 SQL"의 함정
- 언제 무엇을 쓰면 되나
숫자 읽는 법. [공식 문서] 는 구글·앤트로픽 등이 직접 낸 자료, [논문] 은 공개 논문, [직접 측정] 은 저희가 이 맥에서 직접 돌려 잰 숫자입니다.
1. RAG와 OKF는 무엇인가
RAG(조각 찾기)
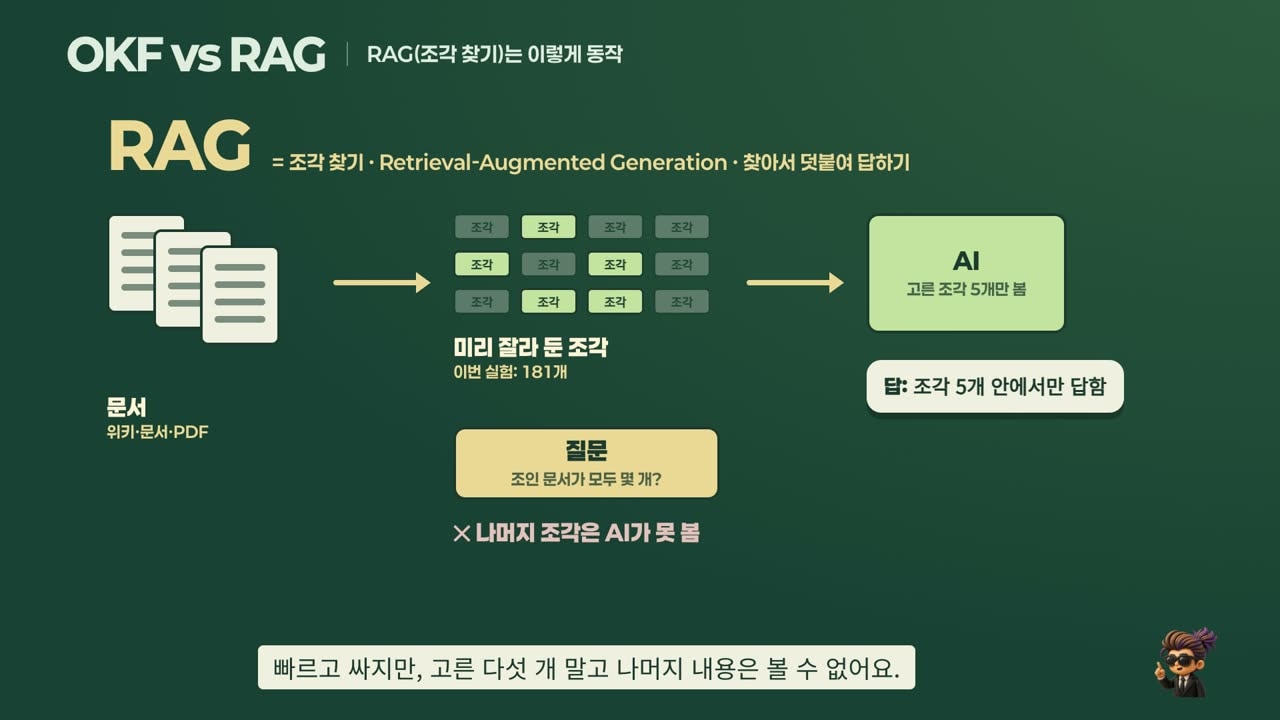
RAG(Retrieval-Augmented Generation) 는 "찾아서 덧붙여 답하기"라는 뜻입니다. 2020년 페이스북 AI 연구소 논문에서 나온 이름입니다 [논문] (Lewis et al. 2020).
- 문서를 작은 조각으로 미리 잘라 둡니다.
- 조각마다 글을 숫자 목록으로 바꿔 둡니다. 이것을 임베딩이라고 하는데, 숫자가 가까우면 뜻이 비슷한 글입니다.
- 질문이 들어오면 질문도 숫자로 바꾸고, 가장 비슷한 조각 몇 개(보통 5개)만 골라 AI에게 붙여 줍니다.
빠르고 쌉니다. 대신 고른 조각 밖의 내용은 볼 수 없습니다.
OKF(폴더 탐색)
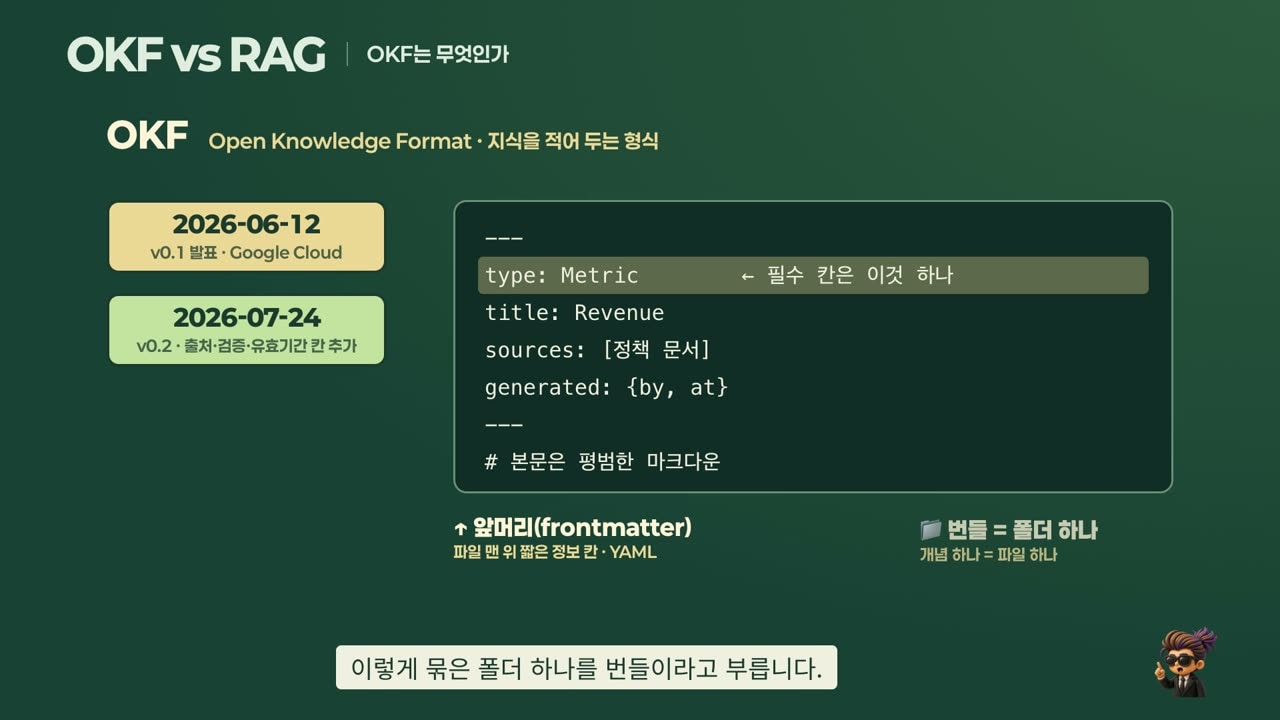
OKF 는 구글 클라우드가 2026년 6월 12일에 발표한 지식 형식입니다 [공식 문서] (Google Cloud 블로그). 7월 24일에 두 번째 버전(v0.2)이 나왔습니다 (사양).
- 폴더 안에 마크다운 파일을 두고, 개념 하나에 파일 하나.
- 파일 맨 위의 앞머리(frontmatter) 에 짧은 정보를 적습니다. 꼭 있어야 하는 칸은
type하나뿐입니다. - 파일끼리 링크로 잇고, 폴더마다
index.md가 목차 역할을 합니다. - 이렇게 묶은 폴더 하나를 번들(bundle) 이라고 부릅니다.
AI는 목차부터 읽고 링크를 따라 필요한 파일을 직접 엽니다. 단어로 검색할 수도 있습니다. 대신 파일을 여러 번 여는 만큼 시간과 토큰이 더 듭니다.
둘은 층이 다르다
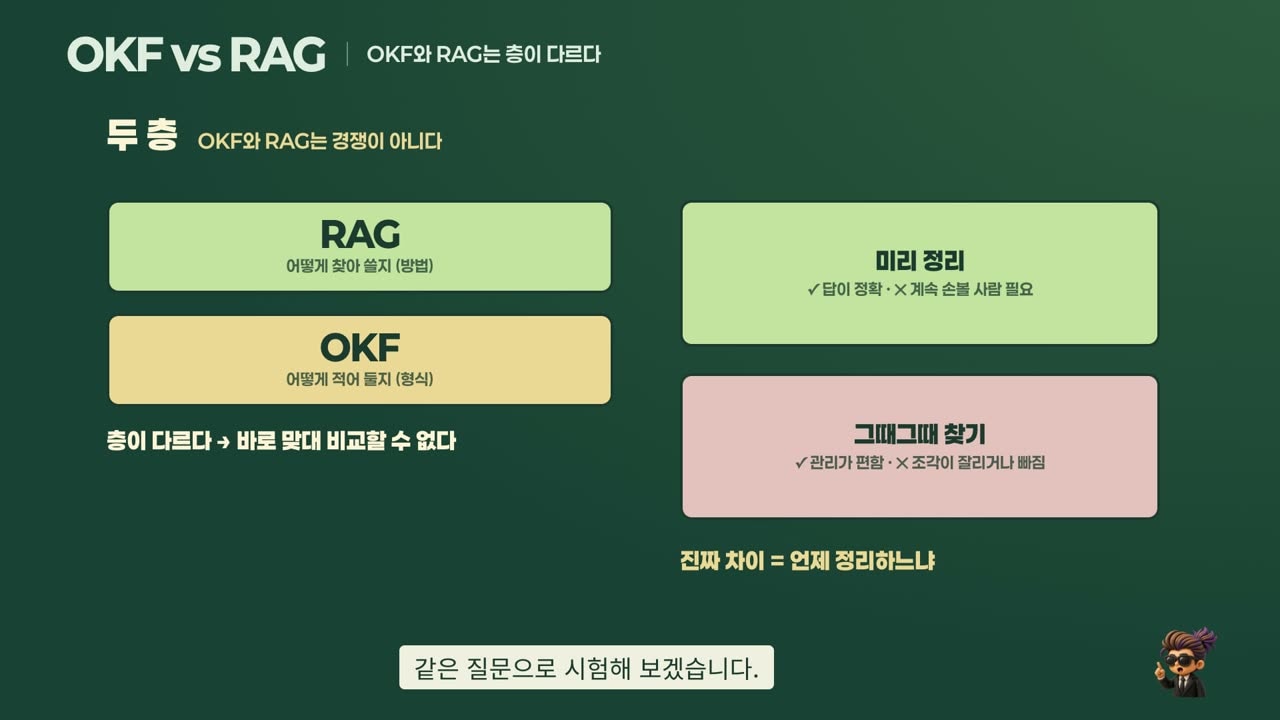
중요한 점이 있습니다. OKF는 지식을 어떻게 적어 둘지 정한 형식이고, RAG는 어떻게 찾아 쓸지 정한 방법입니다. 구글 발표 글과 사양 어디에도 "RAG를 대체한다"는 말은 없습니다. 진짜 차이는 언제 정리하느냐 입니다. 미리 정리하면 답이 정확해지지만 계속 손볼 사람이 필요하고, 그때그때 찾으면 관리는 편하지만 조각이 잘리거나 빠질 수 있습니다.
2. 구글 저장소 코드에는 무엇이 있나
구글이 공개한 저장소(GoogleCloudPlatform/open-knowledge-format, 커밋 ad30107)를 직접 열어 봤습니다.
- 들어 있는 것은 문서를 만드는 에이전트(Gemini가 BigQuery 테이블마다 OKF 문서를 써 줌)와 그래프 뷰어입니다.
- 에이전트의 도구 목록은 개념 목록 보기, 원본 읽기, 문서 쓰기 같은 것뿐입니다.
- 코드 전체에서
embedding,vector,retriev를 검색하면 0건입니다. 질문에 답하는 코드는 들어 있지 않습니다. [직접 측정]
즉 OKF를 쓰려면 읽는 쪽(검색이든, 폴더를 여는 에이전트든)은 직접 만들어야 합니다.
3. 같은 질문으로 직접 시험
시험 방법
- 자료: 구글 공식 예제 번들 4개(GA4, Stack Overflow, Bitcoin, 구글이 만든 예시 회사 Acme Retail), 마크다운 파일 78개
- 모델: Claude Haiku 5.5 하나로 고정
- 방식 5가지
- RAG: 1,200자 조각 181개를 로컬 bge-m3로 임베딩하고, 비슷한 조각 5개만 붙여 답하게 함
- OKF: 번들 폴더에서
index.md부터 읽고 파일 읽기·찾기·검색 도구를 쓰게 함 - 전부 넣기: 파일 78개를 통째로 넣음
- 원문 RAG: 번들을 만들 때 출처로 쓴 공개 문서 10개를 그대로 조각내 RAG
- 하이브리드: RAG로 먼저 답하고, "찾을 수 없다"고 하면 그때만 OKF로 넘김
- 질문: 쉬운 질문 10개(1회), 어려운 질문 8개(3회 반복), 원문 비교용 8개(3회 반복). 정답지는 번들 원문을 보고 사람이 썼습니다.
쉬운 질문: 정답은 같고, 비용이 다르다
쉬운 질문 10개는 모든 방식이 다 맞혔습니다. 차이는 AI가 읽은 양(토큰)에서 났습니다. [직접 측정]
| 방식 | 질문 하나당 평균 입력 토큰 |
|---|---|
| RAG | 약 6,200 |
| OKF | 약 40,100 |
| 전부 넣기 | 약 68,200 |
쉬운 질문이라면 RAG가 6배 넘게 쌉니다.
전체를 세는 질문: RAG는 4개, OKF는 7개
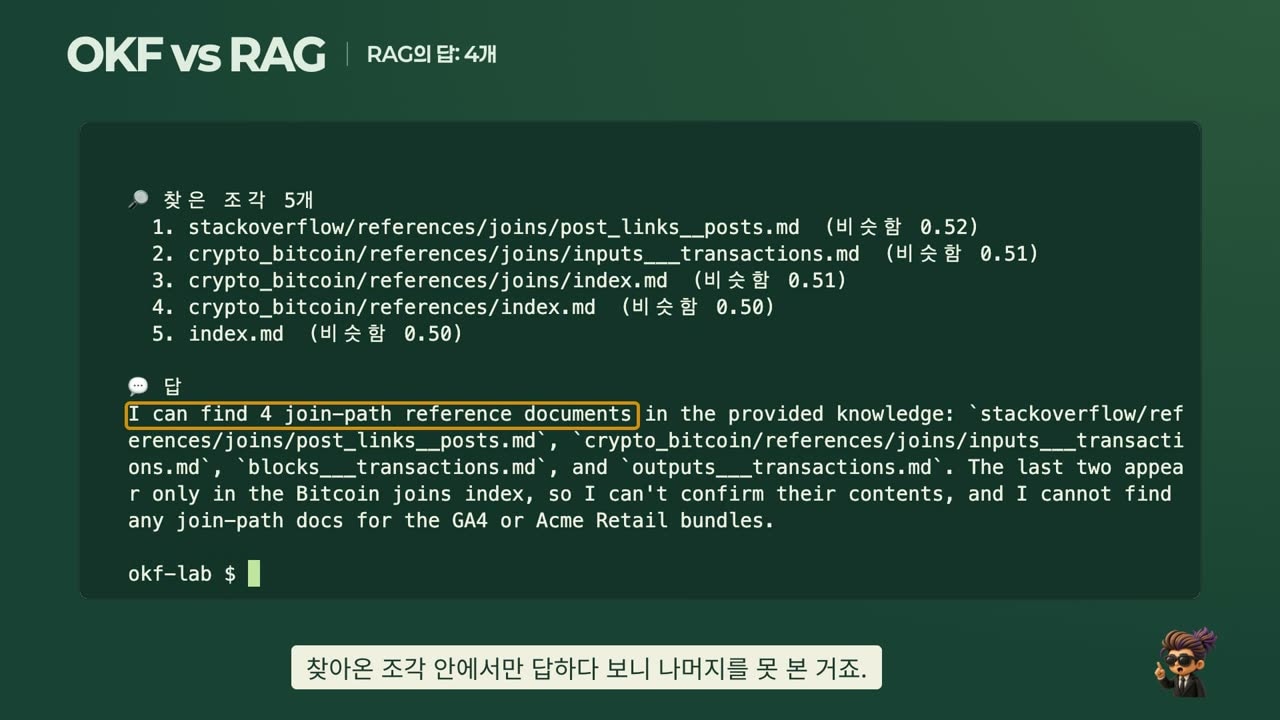
"모든 번들을 통틀어 조인 문서가 몇 개냐"고 물었습니다. 정답은 7개입니다. RAG는 질문과 비슷한 조각 5개를 가져왔는데, Stack Overflow 쪽 조인 문서는 하나만 들어왔습니다. 그래서 4개라고 답했습니다.
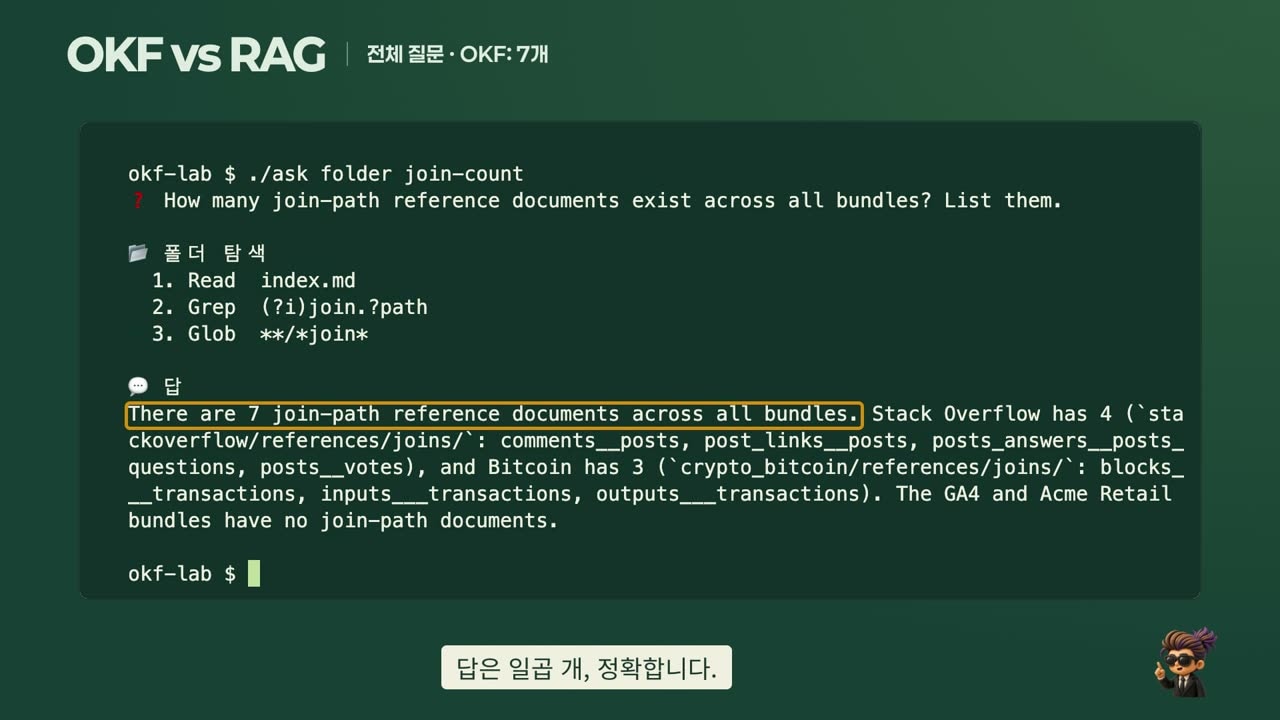
OKF는 목차를 읽고 검색으로 조인 파일을 직접 찾아 7개라고 답했습니다. 세 번 반복해도 RAG는 0/3, OKF는 3/3이었습니다. [직접 측정]
어려운 질문 8개 × 3회 결과
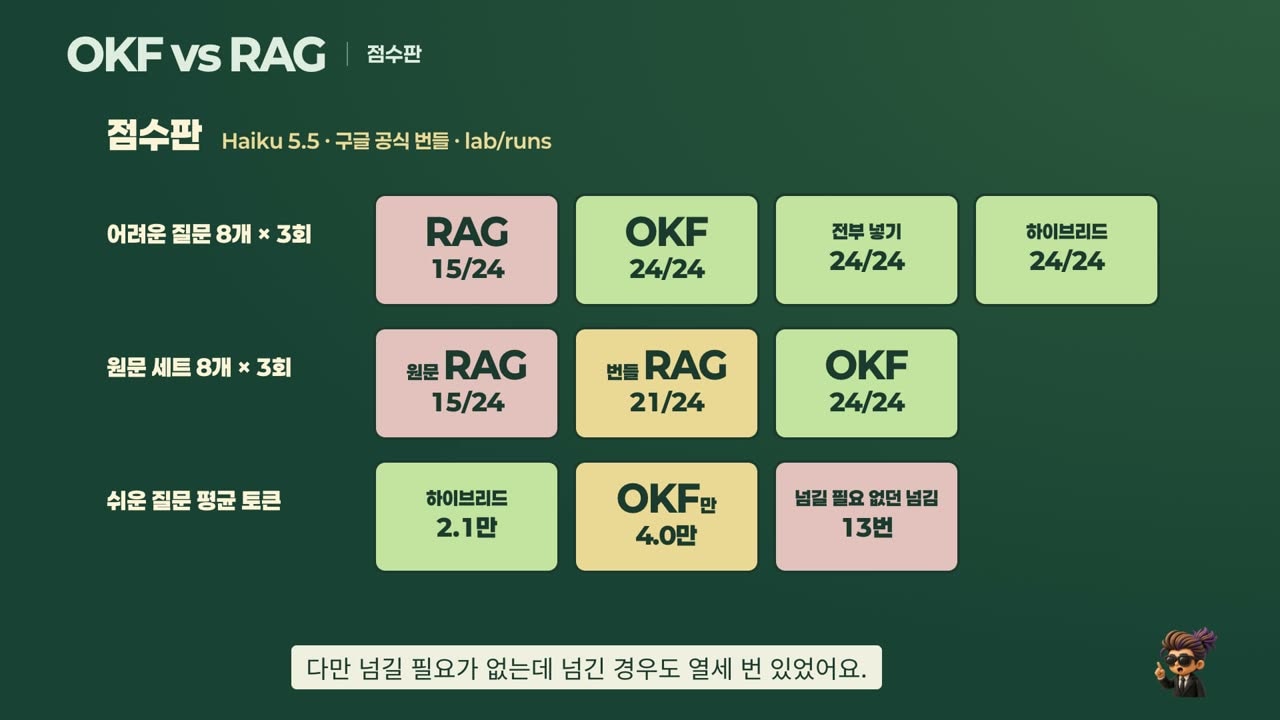
| 질문 세트 | RAG | OKF | 전부 넣기 | 하이브리드 |
|---|---|---|---|---|
| 어려운 질문 8개 × 3회 | 15/24 | 24/24 | 24/24 | 24/24 |
RAG가 진 곳은 세 종류였습니다. [직접 측정]
- 전체를 세는 질문(조인 문서가 몇 개?): 0/3
- 전체를 비교하는 질문(사람이 확인한 번들은 어디?): 0/3. 근거가 부족하다며 "없다"고 말하지 못했습니다.
- 조각이 잘린 질문: 확인해야 할 SQL이 조각 경계에서 중간에 잘려 판단하지 못했습니다(0/3).
다행히 RAG는 틀린 답을 지어내지 않았습니다. 모르면 "확인할 수 없다"고 답했습니다.
OKF에서 검색을 빼면
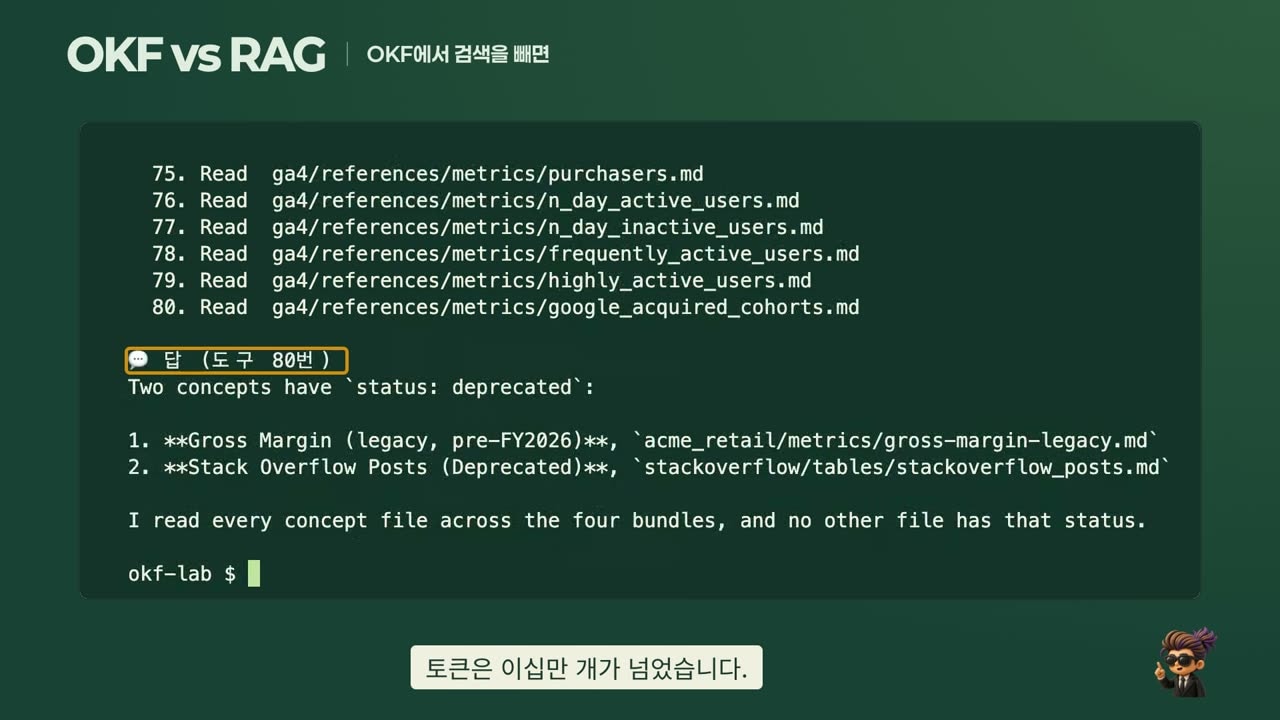
OKF에서 검색 도구를 빼고 링크만 따라 파일을 열게 했더니, "폐기된 개념을 모두 찾아라"라는 질문 하나에 도구를 최대 80번 호출했고 입력 토큰이 20만 개를 넘었습니다. 검색을 허용하면 같은 질문을 두어 번 만에, 약 1만 4천 토큰으로 끝냈습니다. [직접 측정] 폴더가 커지면 "목차만 따라가기"로는 부족하고 검색이 필요합니다.
정리 전 원문에 RAG를 돌리면
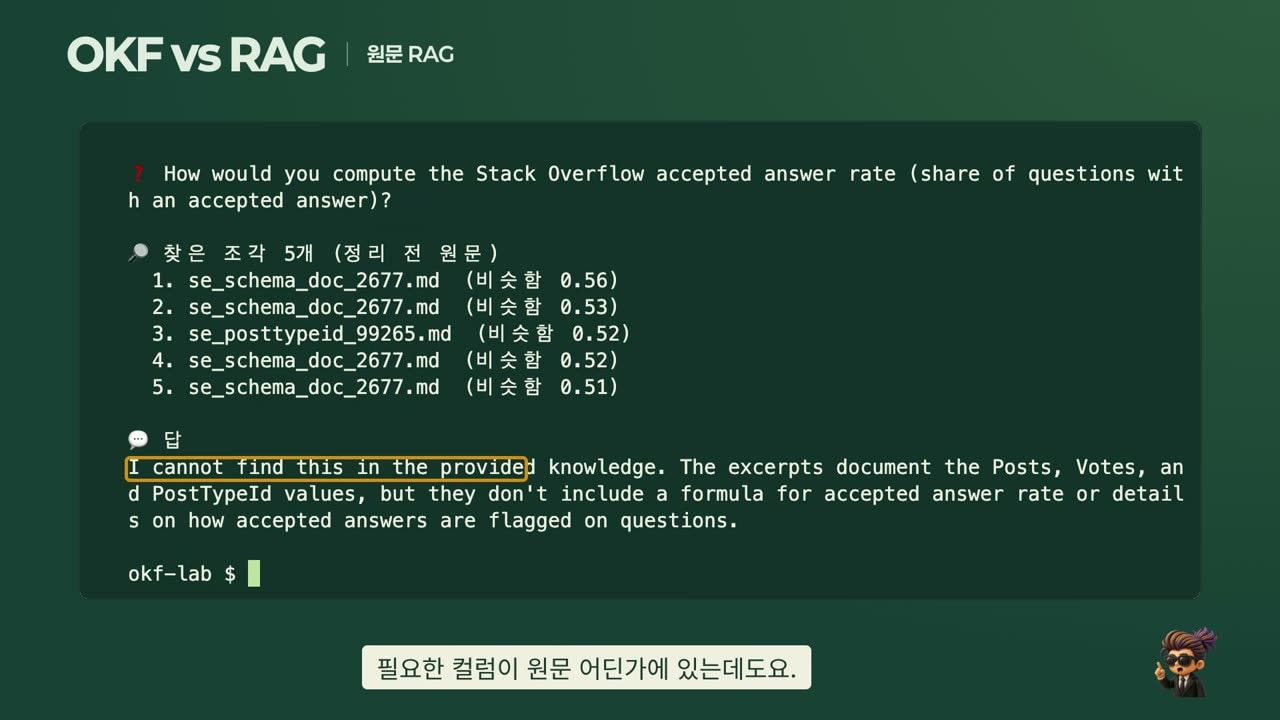
현실에서 흔한 비교는 "원문을 그대로 RAG" 대 "미리 정리한 문서"입니다. 그래서 번들이 출처로 인용한 공개 원문 10개(Stack Exchange 스키마 문서, GA4 공식 문서, Bitcoin ETL 문서 등)를 따로 색인해 같은 질문을 던졌습니다. [직접 측정]
| 방식 | 정답 (8문항 × 3회) |
|---|---|
| 원문 RAG | 15/24 |
| 정리된 번들 RAG | 21/24 |
| OKF | 24/24 |
원문 RAG는 "채택 답변 비율을 어떻게 계산하나"에 "찾을 수 없다"고 답했습니다. 필요한 컬럼(AcceptedAnswerId)이 원문 어딘가에 있는데도 그 조각을 찾지 못했습니다. 정리된 번들에는 계산식이 한 줄로 적혀 있어서 바로 답이 나왔습니다. 번들에서 새로 정의한 지표는 원문에 아예 없으니 당연히 몰랐습니다. 미리 정리해 둔 문서의 힘이 가장 크게 보인 곳입니다.
하이브리드: 싼 방법 먼저, 못 찾으면 비싼 방법
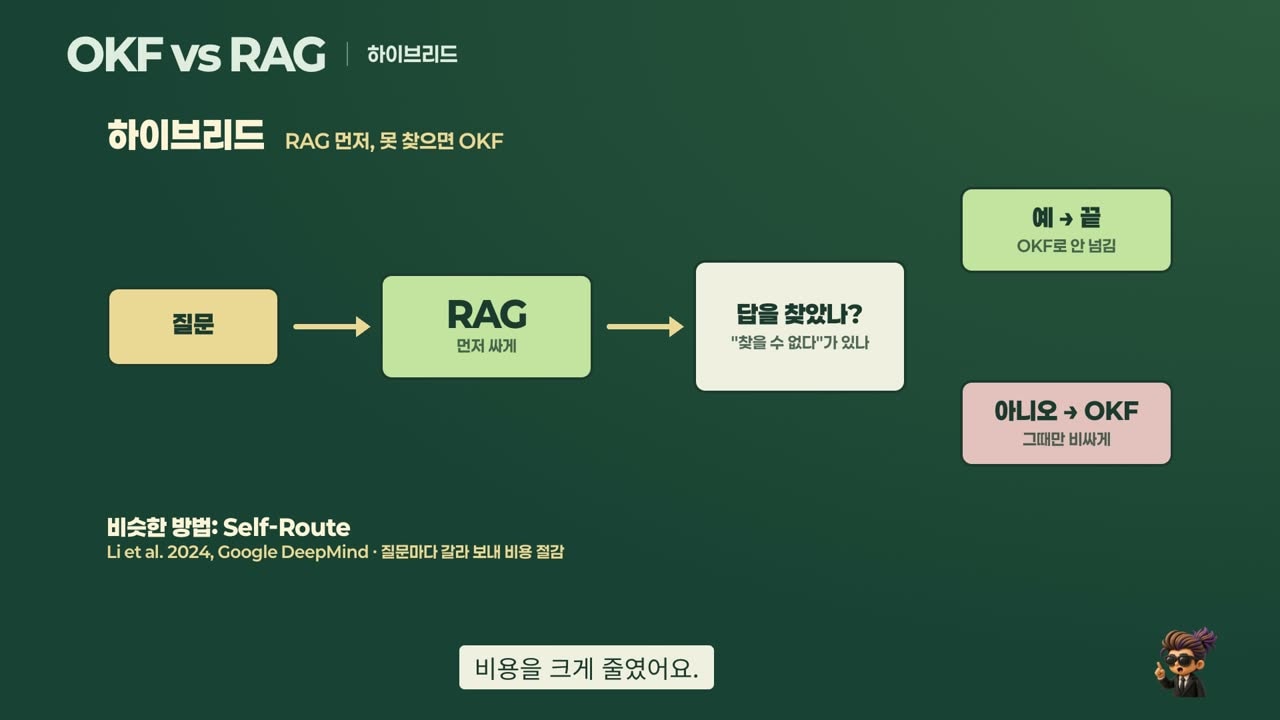
마지막으로 둘을 섞었습니다. RAG로 먼저 답하게 하고, 답에 "찾을 수 없다"가 있으면 그때만 OKF로 넘깁니다. 구글 딥마인드의 Self-Route 연구도 질문마다 이렇게 갈라 보내 비용을 줄였습니다 [논문] (Li et al. 2024).
- 쉬운 10문항 10/10, 어려운 24회 24/24, 합계 34/34 정답 [직접 측정]
- 쉬운 질문에서는 OKF만 쓸 때보다 토큰이 절반(2.1만 대 4.0만)
- 다만 RAG가 맞혔을 질문인데도 넘긴 경우가 13번 있었습니다. "답은 맞는데 일부는 확인할 수 없다" 같은 문장에 넘기는 규칙이 걸렸기 때문입니다.
4. "사람이 확인한 SQL"의 함정
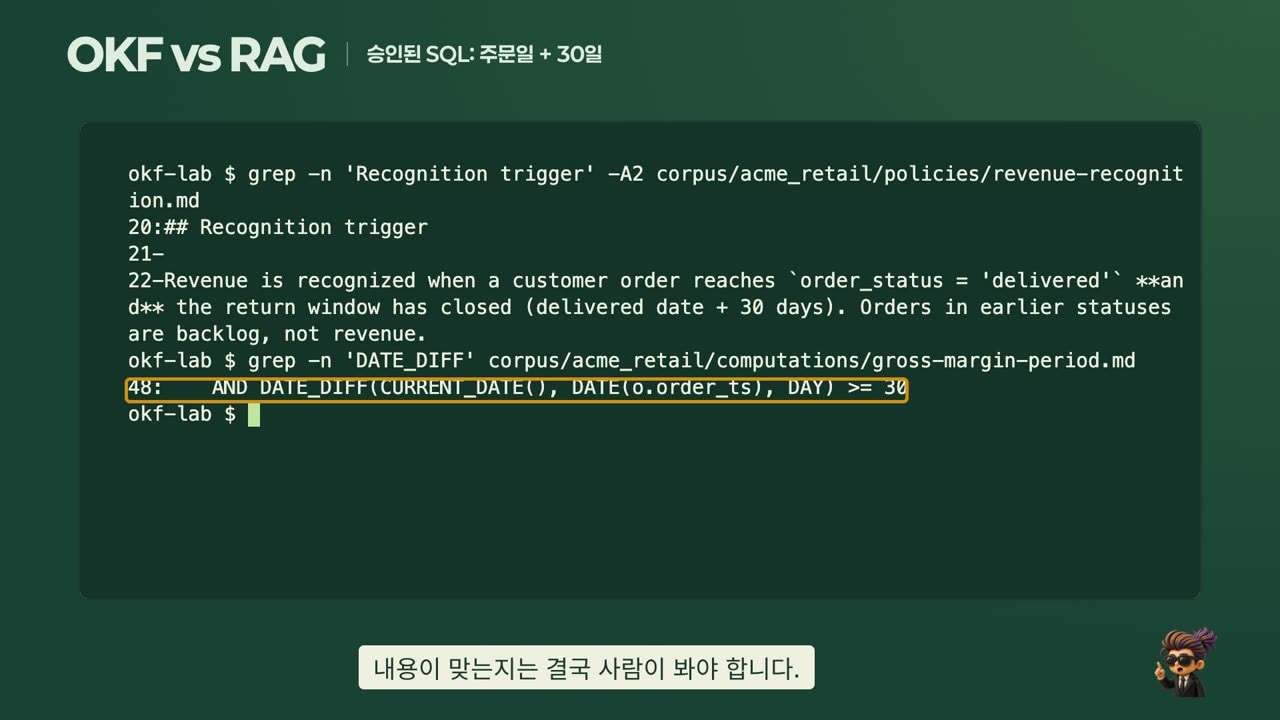
OKF 두 번째 버전에는 신뢰 장치가 생겼습니다. 누가 확인했는지(verified), 언제까지 유효한지(stale_after), 그리고 증명(attestation) 입니다. 증명은 "지금 실행한 SQL이 승인된 SQL과 똑같은지"를 확인하는 검사입니다.
구글 예제 회사 Acme Retail의 매출총이익 SQL은 사람이 확인했고(verified: human:jsmith), 증명 대상으로 승인돼 있습니다. 그런데 직접 읽어 보니 어긋난 곳이 있었습니다.
- 회사 정책: 배송이 끝나고 30일이 지나야 매출로 친다
- 승인된 SQL:
DATE_DIFF(CURRENT_DATE(), DATE(o.order_ts), DAY) >= 30, 즉 주문한 날부터 30일
그래도 증명은 통과합니다. 승인본과 같은 SQL이니까요. 사양에도 "검증과 증명은 다르다"고 적혀 있습니다(SPEC §10.6). 표시와 검사가 있어도, 내용이 맞는지는 결국 사람이 봐야 합니다. 참고로 공식 번들 4개 중 3개(문서 61개)는 Gemini가 쓴 문서이고 사람이 확인한 기록이 하나도 없습니다. [직접 측정]
5. 언제 무엇을 쓰면 되나
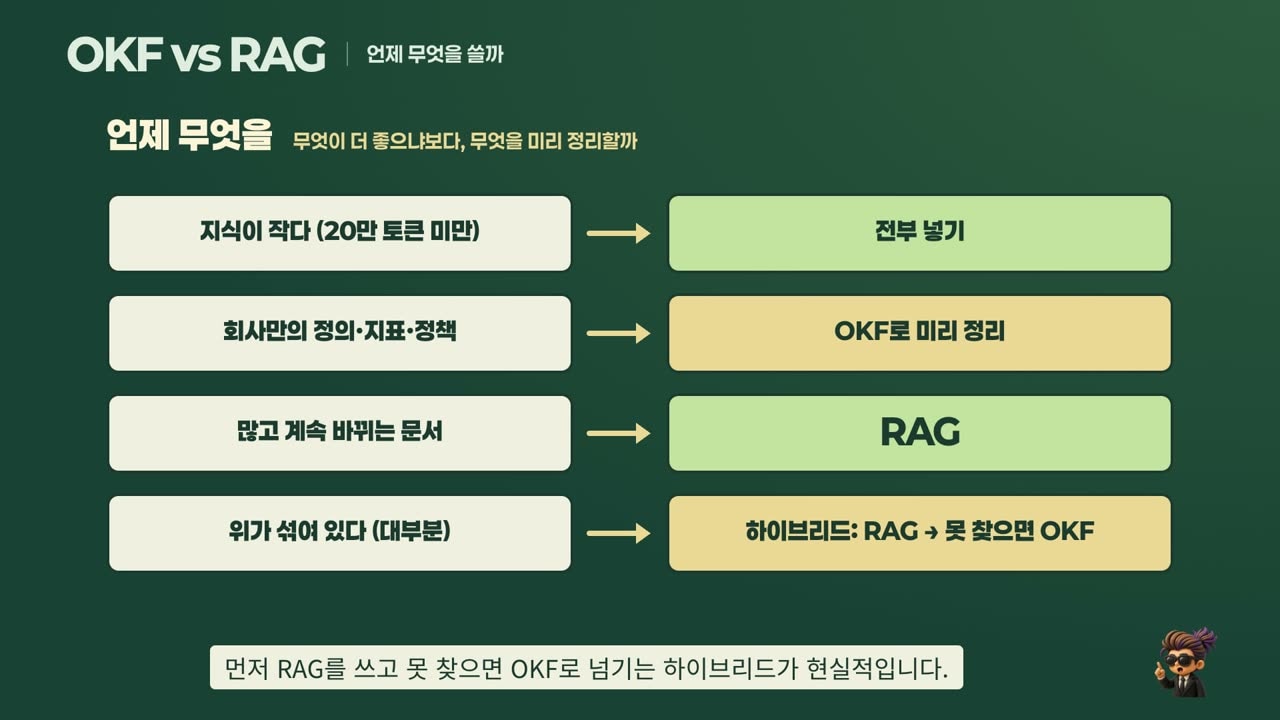
| 이런 지식이면 | 이렇게 |
|---|---|
| 작다(약 20만 토큰 미만) | 전부 넣기. 앤트로픽도 이 크기면 RAG 없이 통째로 넣으라고 권합니다 [공식 문서] (Contextual Retrieval) |
| 회사만의 정의·지표·정책 | OKF로 미리 정리. 원문에는 그 정의가 없습니다 |
| 많고 계속 바뀌는 문서(티켓·회의록·PDF) | RAG |
| "전부 몇 개?", "어디에 없나?" 같은 질문 | OKF(검색 허용) |
| 위가 섞여 있다(대부분의 회사) | 하이브리드: RAG로 먼저 찾고, 못 찾으면 OKF |
"무엇이 더 좋으냐"보다 "무엇을 미리 정리해 둘 가치가 있느냐" 를 먼저 물어보면 답이 나옵니다.
이번 시험의 한계
- 모델 하나(Claude Haiku 5.5), 구글 예제 번들 하나와 그 원문 10개로 시험했습니다.
- 어려운 질문 중에는 RAG가 약한 곳을 일부러 고른 것도 있습니다. 숫자보다 어떤 질문에서 무엇이 약한지를 가져가시면 좋겠습니다.
- RAG는 기본 설정(조각 1,200자, 임베딩 bge-m3, 상위 5개) 하나로만 돌렸습니다. 키워드 검색(BM25)이나 재순위를 더하면 결과가 달라질 수 있습니다.
영상으로 보기
같은 내용을 실제 실행 화면과 함께 영상으로 정리했습니다. 10월 31일 오후 6시(한국시간)에 공개됩니다.
출처
- Google Cloud, Introducing the Open Knowledge Format (2026-06-12)
- GoogleCloudPlatform/open-knowledge-format — SPEC.md v0.2, 커밋
ad30107 - Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- Li et al., Retrieval Augmented Generation or Long-Context LLMs? (2024)
- Anthropic, Introducing Contextual Retrieval (2024)